דילוג לתוכן
0
  • דף הבית
  • חוקי הפורום
  • מדריכים
  • פוסטים אחרונים
  • לא נפתר
  • תגיות
  • פופולרי
  • משתמשים
  • תרומות לאוצריא
  • צור קשר
  • דף הבית
  • חוקי הפורום
  • מדריכים
  • פוסטים אחרונים
  • לא נפתר
  • תגיות
  • פופולרי
  • משתמשים
  • תרומות לאוצריא
  • צור קשר
עיצובים
  • בהיר
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • כהה
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • ברירת מחדל (ללא עיצוב (ברירת מחדל))
  • ללא עיצוב (ברירת מחדל)
כיווץ
לוגו אתר

פורום אוצריא

אוצריא - דף הבית
|
קח שותפות בהוספת ספרים
|
תרום לאוצריא
111

11

@11
הפסקת מעקב מעקב
אודות
פוסטים
112
נושאים
12
שיתופים
0
קבוצות
0
עוקבים
0
עוקב אחרי
0

פוסטים

פוסטים אחרונים הגבוה ביותר שנוי במחלוקת

  • הצעת ייעול | הגהה של ספרים באתר
    111 11
    אתר העריכה 'ספריית אוצריא' הצעה לפיתוח ספריית אוצריא ocr עריכת ספרים

    שוחחתי הבוקר בארוכה עם המומחה שלי לענייני סטטיסטיקה ותוכן.
    מה שיצא לנו זה זה רעיון בערך כזה (מקווה לנסות ליישם בקרוב):

    1. לקחת מאגר ספרים גדול מאוד של סריקות, כמו לדוגמה היברובוקס, ולהריץ מודל ocr, אבל להכניס ממנו רק את התוצאות שמוגדרות בסריקה כרמת וודאות של 95 אחוז ומעלה (רוב כלי הOCR גם כותבים רמת וודאות).
    2. המילים הנ"ל נכנסות למאגר מילוני, וכעת התוכנה מחפשת מילים שאינן במילון שיכולות להכנס בעזרת החלפת אות אחת (אולי עדיף בשלב ראשון רק החלפת אותיות דומות בעברית, כמו ה' וח' או ב' וכ').
    3. המילון מחליף את התמונה, ובו זמנית מזהה שמהיום תמונה של בראשיח היא בעצם בראשית, וזה נכנס לרמת וודאות גבוהה ונוסף למילון כבראשית.
    4. בכל הרצה נוספים מילים נוספות למילון, בשעה שמילה שאינה קיימת בעברית/לשה"ק לא תוכל להכנס אלא אם היא ברמת וודאות של 100 אחוז.
    5. הרצה נוספת שצריך לשקול באיזה שלב, לקחת קורפוס כזה או אחר (יש כמה חינמיים), ולהוסיף למילון לאחר שמיצינו את הבעיות. (בו זמנית כל קורפוס מכיל סטטיסטיקות של סבירות תדירות אותיות, צריך לשקול שימוש בזה).
    6. הרצה נוספת שצריך לשקול באיזה שלב, חיפוש רצף מילים, נניח 10 מילים זהות שנמצאות במקום אחר בשינוי אות אחת, שיבנה לפי סטטיסטיקות. אחר כך יורד ל9 וכן הלאה.

    כל זה נשמע מסובך מאוד, כי זה מסובך מאוד, אבל כבר אמר הגר"א שהעקשן יצליח, ואני מתכוון בעז"ה להתעקש.
    הבעיה הגדולה כאן היא שכל טעות בתכנון עלולה לעלות ביוקר רב. ולכן אשמח לכל משוב ותוספת רעיונות וכו'.


  • הצעת ייעול | כמה שיפורים שאני ממליץ בחום רב
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח עיצוב ניווט חיפוש

    תרשו לי גם לסכם את השיחה שלי עם @י.-פל. בקצרה. (כותב כאן מזכרון, והזיכרון שלי קצת חלוד).
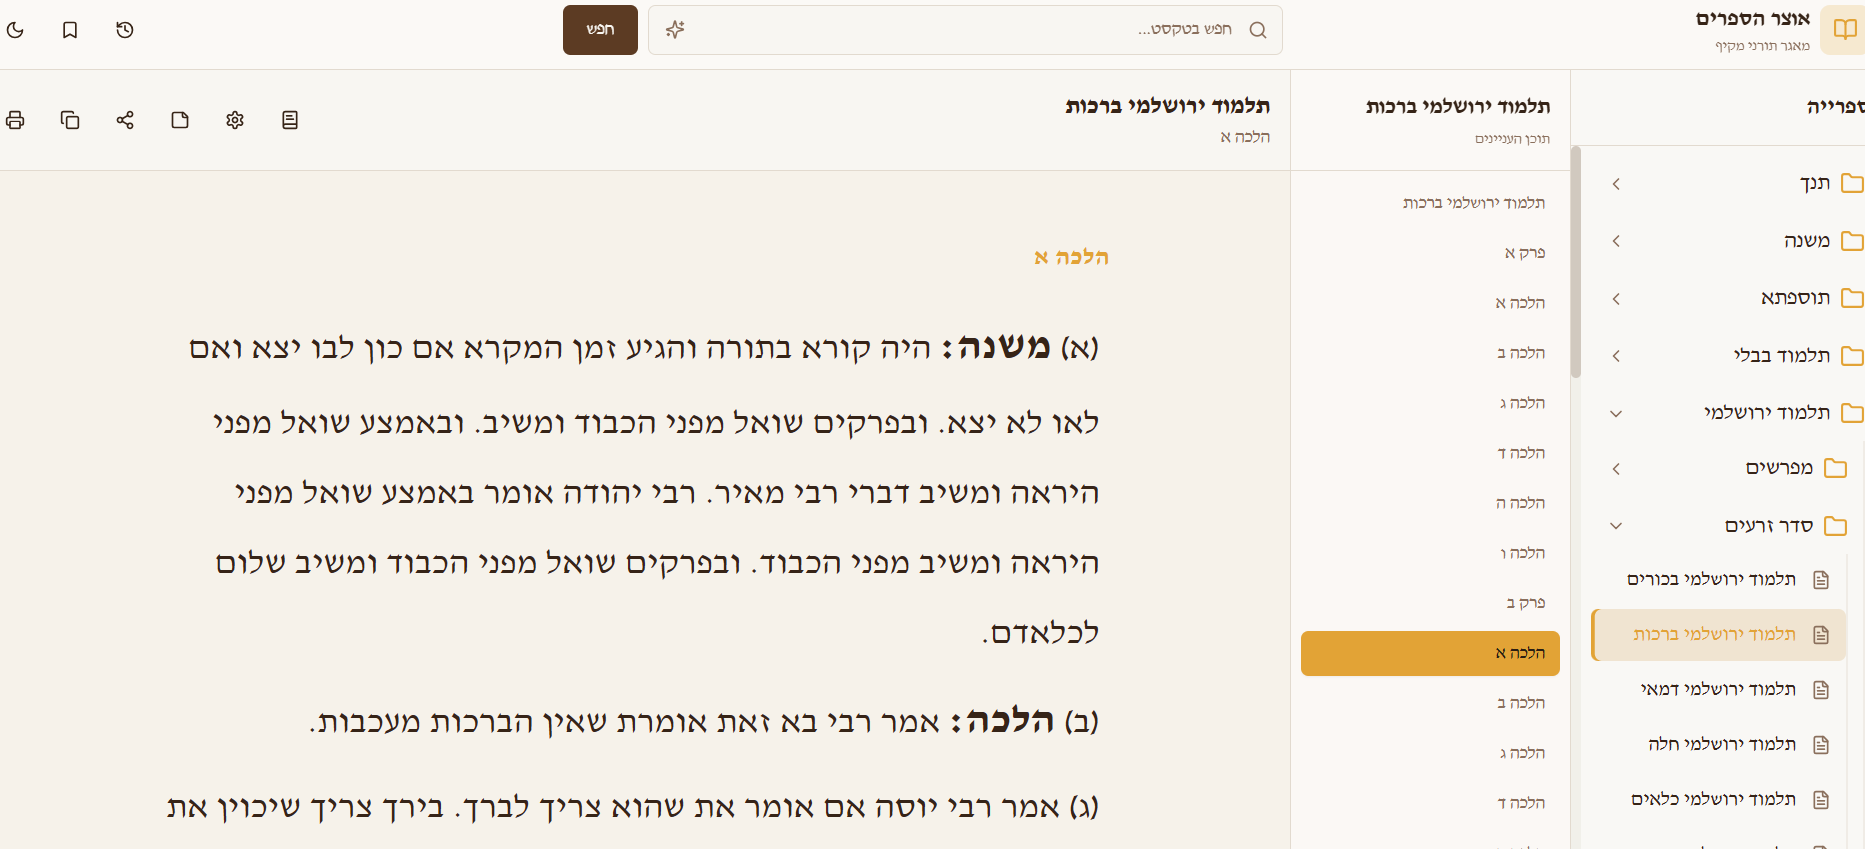
    הפורמט הנכון לדעתי, הוא כעין מה שעושים באוצר החכמה. באותו מסך יש שורת חיפוש ורשימת ספרים (אפשר בקלות גם להוסיף טאב שיסתיר את הרשימה בעת עיון בספר) ליד זה רשימת תגיות (כמו בתמונה ששלחתי כאן בתחילה) שמאפשרת להגיע למיקום ספציפי בספר בלי לפתוח רשימה ולגלול את המקלדת עד שהמפרק של הזרוע חורק, ובקיצור הכל במסך אחד. כל העולם עובר לכמה שפחות מסכים, ולא בהכרח שכולם טועים.
    איך אני יודע? כי חווית השימוש שלי לא נעימה, אני לא טכנופוב גדול, ושמח ואוהב לבחון תוכנות עד למעמקי הקישקעס שלהם, ועדיין הסתבכתי, וגם עכשיו שאני יודע מה קורה זה בעיני הזוי.
    לדעתי כאן זורעים וחורשים וקוצרים, ולשים ומעמרים, ומחפשים מתכון, וכו' וכו', אבל בסוף וכו' וכו'. המשל מובן.

    לגבי מה ש@י.-פל. מכנה שלא בדקדוק מודל rag, יקרא לזה איך שיקרא לזה, בניתי לעצמי מודל שיתן לי תוצאות של בינה מלאכותית, לצורך עצמי. וכיון שבניתי את זה לצורך עצמי היו כאן כמה בעיות.

    1. אני לא יכול לשתף באינדקס הזה כמו שהוא כי הכנסתי לשם כל מיני קבצים אישיים, ואין לי ענין שבכל חיפוש באוצריא ימצאו את הבעיות שלי.
    2. האופן שבו בניתי את זה היה אופן מאוד לא חכם, ולכן למרות שבניתי כבר, לו היה לי כח הייתי יוצא אל השוק ובונה חדש. לוקח למחשב ממוצע לבנות אינדקס כזה כמה ימים, ואם טעיתי הכל יורד לטמיון. איי... מה בעלי המוסר היו עושים עם דוגמה כזו...
    3. ב2 מילים (מה ששכחתי להסביר בטלפון וכדאי לחשוב על זה היטב לפני שמתחילים) בניית אינדקס כרוכה מגזירת המידע לחתיכות קטנות, ועקטארים בלע"ז, וסידורו. אלא מאי? שאני חתכתי באופן סיסטמטי כל 500 מילים, עם חזרה של 100 (כך אם זוכר נכון, יתכן שמשהו אחר, אבל שלחתי לך את הקוד השלם פרוש כשמלה על פני המייל בדוק שם), אבל זו טעות נוראה ביותר, כי כיון שיש כבר תגיות של סעיפים וסימנים וכו', הרי שעדיף שלושים מונים לעשות חיתוך לפי זה, וזה ידייק את התוצאות הרבה יותר. מה גם שאפשר לשלב בין שניהם ולבנות אינדקס כפול (שאמנם יתפוס כך וכך ג'יגות אבל יהיה מדוייק בהרבה).

    ולגבי אתר אינטרנט.
    היתרון באתר הוא המהירות והאכסון והפונקציונליות.
    המהירות - לא קריטית במיוחד, גם אם יש לכם מחשב יד שניה, אין הפרש גדול במהירות ההפעלה, אבל תיקונים ועדכונים וכו' לא מתעדכנים אוטומטית.
    האכסון - אם רוצים גם מנוע בינה מלאכותית - זה תופס נפח של פי 2 מהנפח הקיים כיום. לפחות. ואם רוצים משהו יעיל מאוד אז יותר. ואם רוצים להוסיף ספרי PDF למיניהם ועוד דברים שתוספים נפח, אין מקום במחשב. (ושוב חוזרים לבעלי המוסר: אם מכניסים לראש וכו' לא נשאר מקום בראש וכו').
    הפונקציונליות - אין אפשרות לחיפושים כמו בגוגל בוקס או באתרים אחרים. אין אפשרות לתקן ספרים אוטומטית לכולם וכן הלאה.

    אבל מה? יש עדיין כמה אנשים שאין להם גישה לאינטרנט אשרי חלקם בזה ובבא (שוב הגענו לבעלי המוסר? מה קורה היום?),
    בשביל זה יש פתרון מאוד פשוט, מה שעושים בכל העולם בכאלו מצבים. בונים תוכנה משולבת. כלומר, תוכנה שתעבוד באופן מושלם ונפלא ומדהים אבל כשתתחבר לאינטרנט יהיו לזה עוד פונקציות, אם לא תתחבר לא יהיה. בדיוק כמו שאתה לא יכול לעדכן את התוכנה בלי חיבור. והאופן הנח לבנות כזה דבר הוא במסך HTML פשוט ולחפש בדפדפן.

    חייב לרוץ כי הראש כולל דוחק, אבל ארחיב לפי הצורך אם וכאשר.


  • בירור | OCR לקבצי PDF לחיפוש בתוכנה
    111 11
    בעיות - תוכנת אוצריא pdf ocr חיפוש

    לעשות OCR לספר, אין פשוט מזה, אסביר לך בשפה שווה לכל נפש:

    בשביל תוצאה מקצועית אתה חייב לגשת ישר לסטרים של הקובץ ברמת הביט, צריך לחלץ את המידע הבינארי הגולמי ולבצע עליו ביטול כימות ידני כדי להימנע מארטיפקטים של דחיסה. אחרי שיש לך את המטריצה הגולמית, תפעיל מסנן מורפולוגי של פתיחה וסגירה כדי לנקות רעשי רקע סטוכסטיים, ומיד אחר כך תחשב את הגרדיאנטים עם אופרטור סובל כדי לבצע זיהוי קצוות וקטורי. רק אז תבצע בינאריזציה אדפטיבית מבוססת מקומותש תתחשב בשונות של הפיקסלים, אחרת הכל יצא לך מרוח בגלל חוסר תאימותפ אזה מרחבית.
    בשלב השני, אתה בונה ארכיטקטורה של רשת עצבית רקורסיבית משולבת עם שכבות קונבולוציה, ומאמן אותה בשיטת על ערכת נתונים ייעודית שתייצר מהגופן של הספר עם אוגמנטציה של עיוותים גיאומטריים. את פלט ההסתברויות של הרשת תזרים לתוך אלגוריתם ויטרבי כדי למצוא את הרצף הסמנטי בעל הסבירות המקסימלית במרחב הוקטורי, ורק בסוף תבצע סריאליזציה חזרה לפורמט יוניקוד, בתנאי כמובן שהקצת נכון את הזיכרון במעבד הגרפי בזמן האינפרנס כדי לא לקבל גלישת מחסנית באמצע הריצה.

    אבל היום יש גם תוכנות שעושות את כל זה לבד, אתה יכול להעזר בהן, יש ברחבי האינטרנט רבים כאלו חינמיים, כולל בעברית.

    נ.ב. מכיר את הסיפור על וכו' שאמר שאם הוא שואל אם מותר לשתות חלב לארבע כוסות צריך לבדוק אם יש לו יין ובשר ומשמנים? ובכן גם כאן הרב אמר שאם יש לך ספר של 7000 עמודים, זה ודאי לא ספר סרוק, כי נפח כזה של ספר סרוק זה לא יפתח לך עעל מחשב נורמלי, ולכן בהכרח מדובר על קובץ וורד וכדומה שהפך לPDF, ללמדינו שמן הסתם כבר יש בו שכבת OCR.
    ויהי לפלא.


  • הצעת ייעול | כמה שיפורים שאני ממליץ בחום רב
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח עיצוב ניווט חיפוש

    זה מורכב מכדי לענות בכן ולא. אבל אם חייבים להגיע לכן ולא אז - יש אופציה חינמית או זולה מאוד.
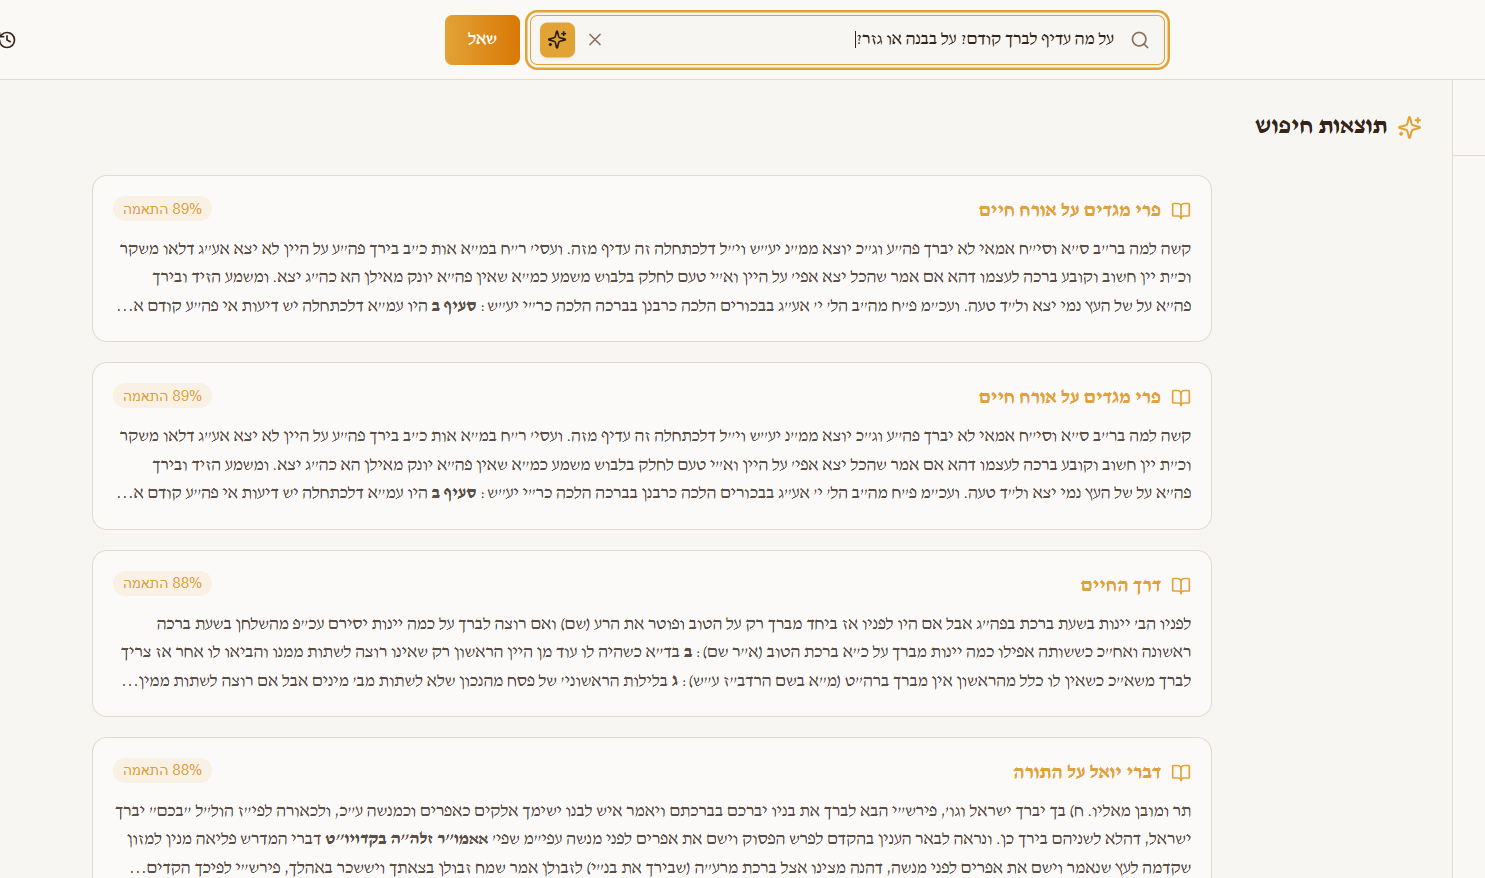
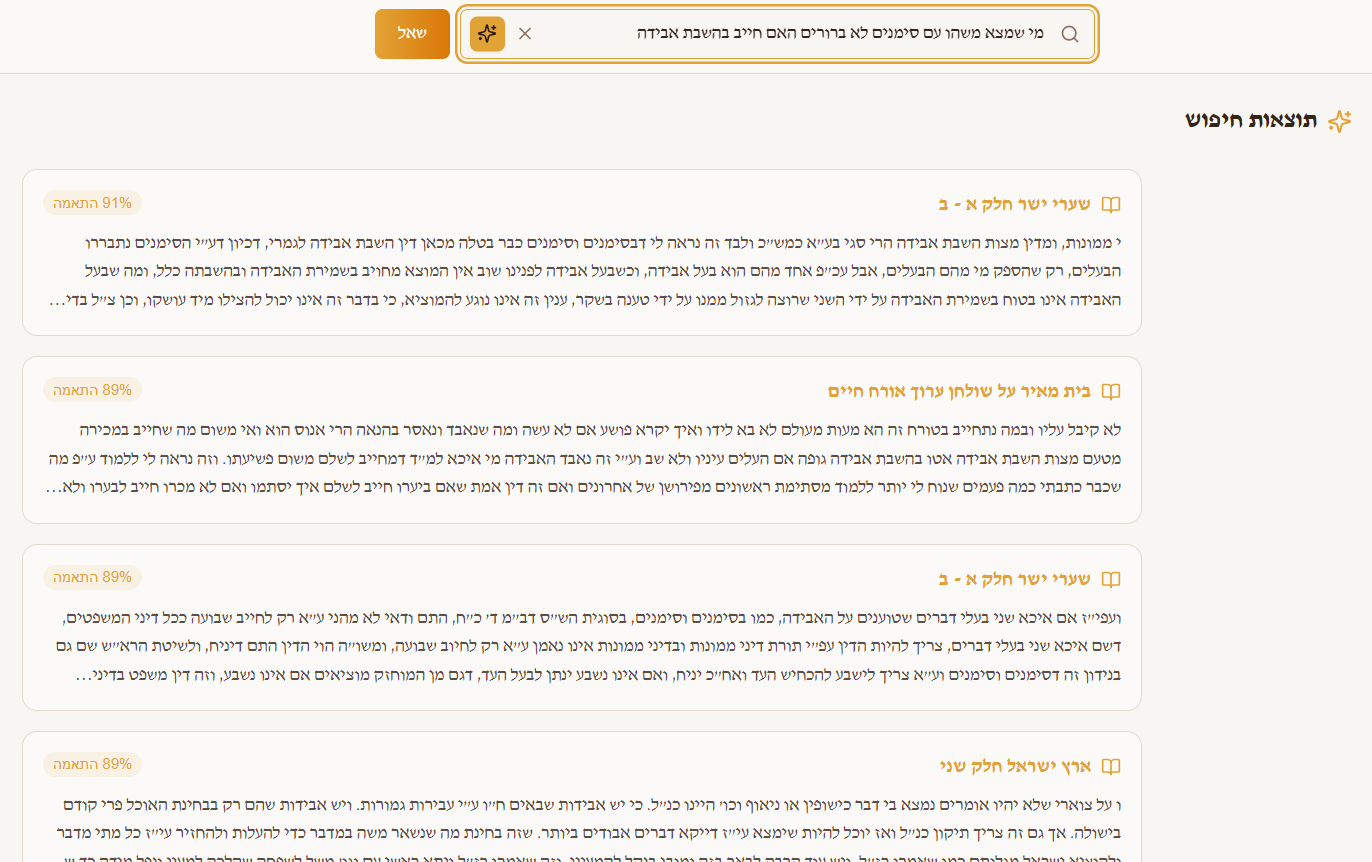
    יש לי לדוגמה מערכת של בינה מלאכותית, שמאפשרת לעשות חיפוש באוצריא ולקבל תוצאות של בינה מלאכותית, כלומר, אתה יכול לשאול מה מברכים על גזר ולקבל תשובה, או מה לעשות אם שכחתי להתפלל וכדומה. מצרף תמונה לדוגמה.

    image.png

    image.png


  • בירור | OCR לקבצי PDF לחיפוש בתוכנה
    111 11
    בעיות - תוכנת אוצריא pdf ocr חיפוש

    זה סתם שפה גבוהה. זה מושגים פשוטים.
    בינארציה אדפטיבית זה לזהות את השחור ולבן בצורה ברורה יותר לפי אזור הטקסט. זה סתם שפה מודרנית לזיל בתר רובא (בגדרי רוב וקרוב, שיזהה כל נקודה לפי רוב האזור שהיא נמצאת בו).
    אופרטור סובל זה גם סתם שפה גבוהה שבאה לבטא איפה נמצא הגבול של הטקסט בזוויות, זה בדיוק כמו דין עיר העשויה כקשת לענין תחום שבת (עירובין שם, שם), אז אותו דבר בדיוק בדף של PDF.
    העקרון מאוד פשוט, זה ענין של מילון.


  • הצעת ייעול | אימון מודל לפיענוח טקסטים
    111 11
    הוספת ספרים לספריית אוצריא הצעה לפיתוח ocr הקלדה

    האפשרות הפשוטה ביותר לפי מה שאני יודע מניסיוני הדל, הוא לבנות משחק ילדים לבין הזמנים, שבו יאשרו צורת אותיות, וכל אות א' שתאושר תכנס למאגר בכל מקום שבו יש עד סטיית 4 פיקסלים.
    אלוף האותיות יזכה בכתר.
    (נכתב קצת פשטני ומאוד עממי, אבל שילוב הפרמטרים הייחודים למאגר תורני כמו היברובוקס, בשילוב חכמת המונים קלה, הוא מצב שיש כאן יתרון גדול שאין לחברות הOCR).


  • המלצה | רשימה שמית ולא בתיקיות
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח שיפור - ספריה מיון

    @י.-פל. כתב בהמלצה | רשימה שמית ולא בתיקיות:

    1. אתה יכול לעשות pull, כל תרומת קוד תתקבל בברכה - אם כי לא בטוח שבהצלחה...

    ענין עקרוני. כמו שאתה רוצה להוציא את האינטרנט מהבית, אני רוצה להוציא את התכנות מהראש. לו ידעתי כמה מיליארדי שעות השקעתי בכל מיני פרוייקטים טובים ופרוייקטים מטופשים, היית מבין למה אני עושה לעצמי סייגים כאלו ואחרים. אל נא באפך.

    1. אני מנסה להבין: מה נותנת לך רשימת שמות - יותר מאשר חיפוש? הלא אתה לא הולך לדפדף ב7,500 כותרים...

    פעמים רבות כן. כגון: אני רוצה להגיד משהו על פרשת השבוע ליד השולחן כמנהג בעלי בתים חשובים, ואני רוצה כעת את רשימת הספרים המלאה של הקטגוריה. לי זה קורה הרבה דברים מעין זה.

    1. לגבי:

    @11 כתב בהמלצה | רשימה שמית ולא בתיקיות:

    את השורה בצד ימין של המודולים להעביר לסמלים למעלה

    כוונתך ללוח השנה?

    לא. כוונתי לכל מה שיש בצד ימין, שזה עין ואיתור וחיפוש וכדומה. אם הסרגל הימני לא יהיה שם, ורשימת הספרים תתכווץ, נשאר חלק מהותי מהמסך לקרוא את הספר.

    @11 כתב בהמלצה | רשימה שמית ולא בתיקיות:

    אפשר לשלב אותם במודול אחד חכם יותר

    אני אשמח להסבר יותר מפורט.

    אסביר.

    1. המודול של איתור הוא זהה למודול של שם ספר עם תוספת פיצ'ר של איתור מדוייק בתוך הספר. אפשר לבטל אותו ולהוסיף את זה לחיפוש ברשימת הספרים שאם אני כותב שמות הוא מראה לי את חומש שמות ואם אני ממשיך לכתוב שמות יא יג הוא ימצא לי את הפסוק ישירות.
      אפשרות שניה, ליד החלונית של שם הספר להוסיף חלונית קטנה לכתיבת המקור המדוייק באותו הספר (עם מעבר באמצעות טאב, כדי לא לעזוב המקלדת). וזה חוזר גם למה שהצעתי בעבר לעשות טור/עמודה של הגעה למקור המדוייק ישירות.
    2. המודול של ספריה ושל עיון הם זהים ומכפילים את עצמם כאשר משתמשים בתצוגה מקדימה. אפשר לבטל את מצב עיון ושיהיה תמיד בתצוגה מקדימה, ולהעביר לשם את הפונקציה של הכרטיסיות.
    3. חיפוש בתוכן הספרים הוא בחלון נפתח בפני עצמו. אפשר במקום זה להוסיף בדף הבית שורה שזה תפקידה.
      כל זה בעצם הופך את התוכנה לדף אחד בודד עם כל הפונקציות. (כמו שבאוצר החכמה עשו אחרי ניסיונות רבים, והם בעצם עברו את כל הדרך שלנו, אז למה לא לקצר ולהגיע למסקנות ישירות).
    4. ההגדרות נפתחות בחלון נפרד. גם זה מכביד. היה כדאי להשתמש בחלון התצוגה לכל דבר, וכשולחצים על הגלגל שיניים (או להחליף את זה לתמונה של קונגו, כי זה המון הגדרות ולא רק בודדות) זה יפתח בחלון התצוגה את רשימת ההגדרות. כנ"ל האודות והתודות.

    אגב, ממש אתמול נזכרתי בך, והחלפתי את הקישור להיברובוקס - במה שהצעת.

    בדיוק ראיתי את זה, ובדיוק רציתי לפתוח לך אשכול של תודות פרחים ונשיקות, אבל הקדמתני. יהי רצון שתעלה לפניך המחשבה למעשה.


  • בירור | OCR לקבצי PDF לחיפוש בתוכנה
    111 11
    בעיות - תוכנת אוצריא pdf ocr חיפוש

    @דאנציג כתב בבירור | OCR לקבצי PDF לחיפוש בתוכנה:

    @11 כתב בבירור | OCR לקבצי PDF לחיפוש בתוכנה:

    (עירובין שם, שם),

    ???

    אז אחרי הכל זה כן בינה מלאכותית, או שאתה משתמש במילון תורני?

    זה על דרך הבדיחותא, היתול, שחוק, הלצה (הלוצ"ע בלע"ז). אם באמת אתה מחפש עיין בדף נ"ז ע"ב.

    אבל לגופו של ענין ברור שאני עושה שימוש נרחב בבינה מלאכותית ורוב חכמתי הימנה, אצלינו בכולל לא הספיקו את כל מה שאני יודע, ובפרט לא בענייני מחשבים.


  • הצעת ייעול | אימון מודל לפיענוח טקסטים
    111 11
    הוספת ספרים לספריית אוצריא הצעה לפיתוח ocr הקלדה

    @צדיק-וטוב-לו כתב:

    @arieldaniely כתב:

    באמת גוגל עשו את זה פעם ועבד להם מדהים - הם עשו "אני לא רובוט" בו צריך להקליד מילים מטושטשות כאשר הם ידעו רק חלק מהם וכך אימנו מודל שהיה טוב יותר מבני אדם! [בני אדם מצליחים בשיעור של 66% בערך והוא בערך 98%!]

    מעניין.
    יש לך את המקור?

    @11 כתב:

    הפרמטרים הייחודים למאגר תורני כמו היברובוקס,

    כלומר?

    יש כמה פרמטרים שמייעלים, כמו צבעים שחור ולבן בלבד. ללא מספרים.
    אבל בעיקר נתון מאוד בסיסי וחשוב, שמשום מה לא נראה שנעזרו בו: כל הספרים שהפענוח שלהם גרוע,כלומר 70-100 שנה ואחורה, הם כולם מכמה עשרות בודדות של בתי דפוס, שהיו להם בסך הכל גופן או שנים לכל בית דפוס לאורך כל חייו.
    כלומר, ספק אם בכלל יש מאה גופנים שונים בכל הספרים הישנים שבכל אוצר החכמה/היברובוקס כולו. (בחדשים יש הרבה, אבל זה הקריאים יותר).
    אם יש 27 אותיות בעברית פחות או יותר, ויש נניח 100 גופנים, זה אומר שלכל היותר יש 2700 סימנים שונים. אם אנחנו מזהים את כולם ומוודאים שכל מי שנדפס בבתי הדפוס הללו לא יוכל להכיל שום דבר מלבד זה, נקבל מהר מאוד תוצאה מושלמת (כולל אפשרות לחידוד גופניםב קלות).
    משחק מחשב לזיהוי 2700 גופנים שיחולק בין כל ילדי ישראל (1200 סניפי אבות ובנים כפול 60 ילד בממוצע) יש לנו למעלה מ25 ילדים לזיהוי כל תו.
    (המספרים האחרונים משוערים בואכה מומצאים).


  • הצעת ייעול | תוכנה לחיפוש בPDF
    111 11
    הצעות לשיפור - תוכנת אוצריא תוכנות עזר pdf חיפוש בוט

    כתבתי לבוט האהוב עלי פרומפט כזה:
    יש לי על המחשב כמה תוכנות חיפוש. אני רוצה תוכנה יעילה לחיפוש ועיון בקבצי PDF. יש לי קבצים שהורדתי מהיברו בוקס (מורש לשימוש אישי) ומהספריה הלאומית (נחלת הכלל) ועוד. תבנה לי את התוכנה הכי יעילה שיש.

    קיבלתי משהו.

    לאחר מכן פניתי לבוט אחר וביקשתי שישפר כל מה שעולה בדעתו. לאחר ששיפר חזרתי לבוט הראשון וכנ"ל, וככה תיזזתי את התוכנה בין 4 בוטים אהובים לי כבנים. (עם הנחיה אחת שמבקשת לתעד מה שנעשה ולא לשבור לבוט אחר את המילה כדי שלא יגרום לו לשנות הלוך חזור שוב ושוב).

    אחרי כחודש ואין סוף בקשות חוזרות (אולי 100 כאלו), קיבלתי את התוכנה הבאה. (עם מעט התערבות אנושית).
    לפני שאני מעמיד אותה לרשותכם לתועלת הרבים, (חינם כמובן, אבל אין לי אפשרות לשלם מלגות למשתמשים...), אשמח אם כל מי שרוצה משהו יבקש אותו, כדי שאריץ שוב ושוב בין ידידי האהובים עד שיהיה משהו מושלם לעילא ולעילא, עד שמלאכי השרת יעמדו ויהללו ויאמרו "אין תוכנה כזו בכל הארץ".
    (אני במקביל מריץ משהו לחיפוש בעזרת בינה מלאכותית, אבל זה עדיין לא).

    2c1723d3-345c-4f77-8b51-dbba73cdc620-image.jpeg


  • בעיה | חסרה הדרכה בסיסית לספרים בעלי כמה מפרשים
    111 11
    בעיות - ספריית אוצריא מדריך מפרשים אזור אישי

    כדאי לתת את הדעת על ענין שיש לו השלכות בזה, שיש הרבה הבדלים בין אותו ספר ממש. וההבדל בין חידושי הרמב"ן של מוה"ק לשל הירוקים לשל השחורים וכו' הם הבדלים עצומים. בבר אילן כתבו לכל ספר מה ההוצאה שלו. בספריא כנ"ל. בספריית אוצריא אם לא תהיה מדיניות כזו (בהנחה שלא יהיה קישור לPDF), צריך להתוות קו ברור איך בוחרים ספר.


  • באג | פרטי ספר שיש PDF
    111 11
    בעיות - תוכנת אוצריא באג pdf היברובוקס

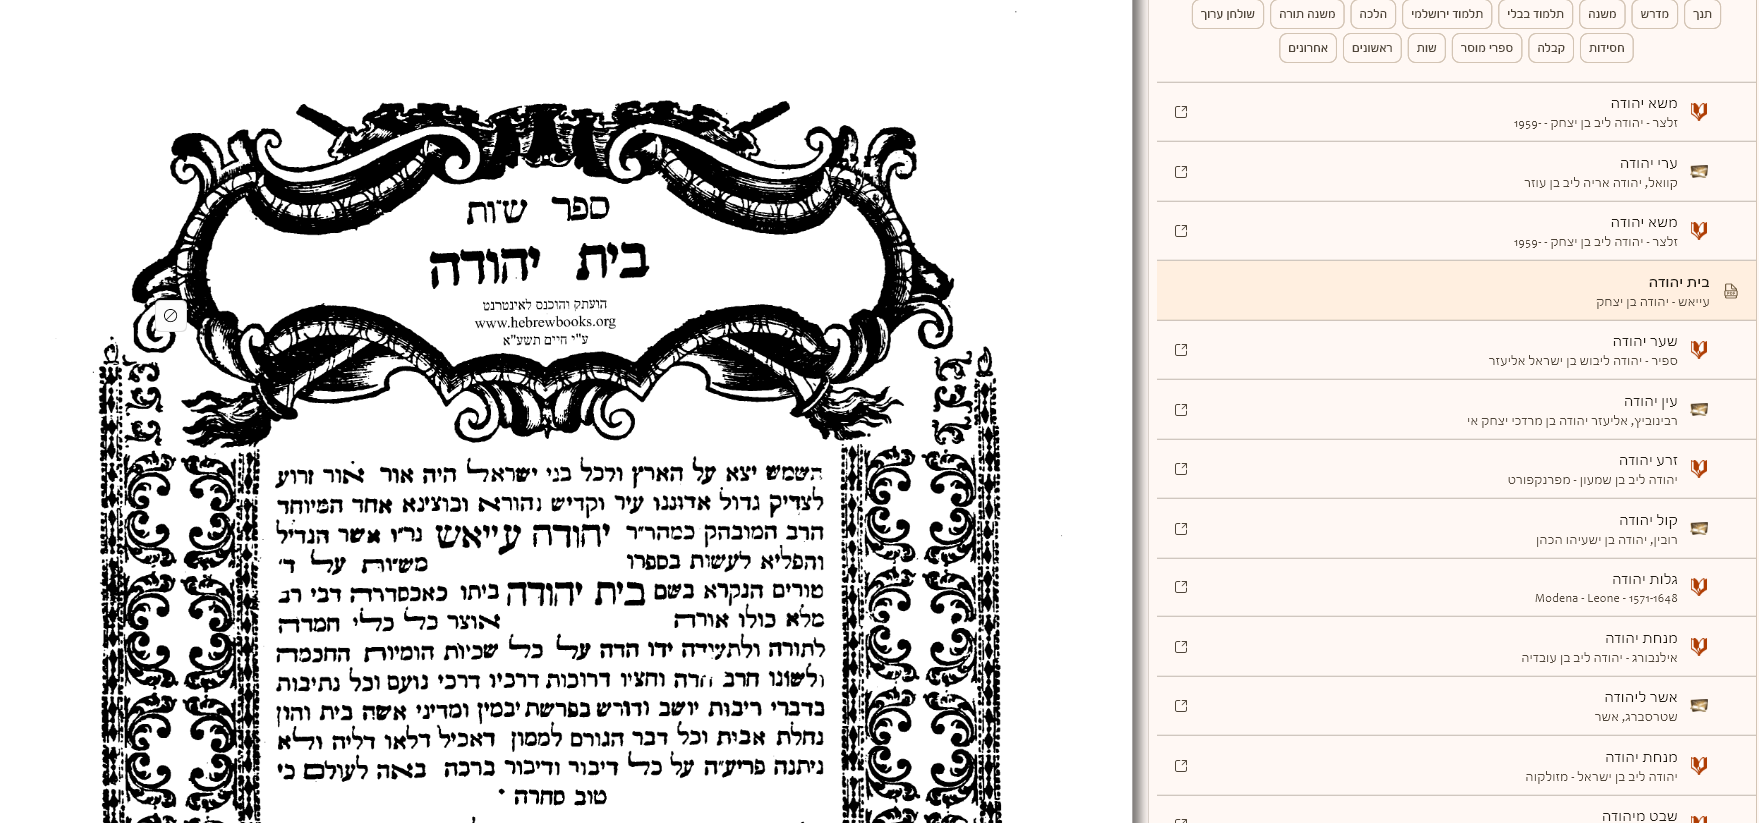
    image.png

    מי גילה לאוצריא שיש לי את הספר בית יהודה? זה מובנה. כשיש לי אותו זה מזוהה לבד דרך האינדקס.


  • הצעת ייעול | כמה שיפורים שאני ממליץ בחום רב
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח עיצוב ניווט חיפוש

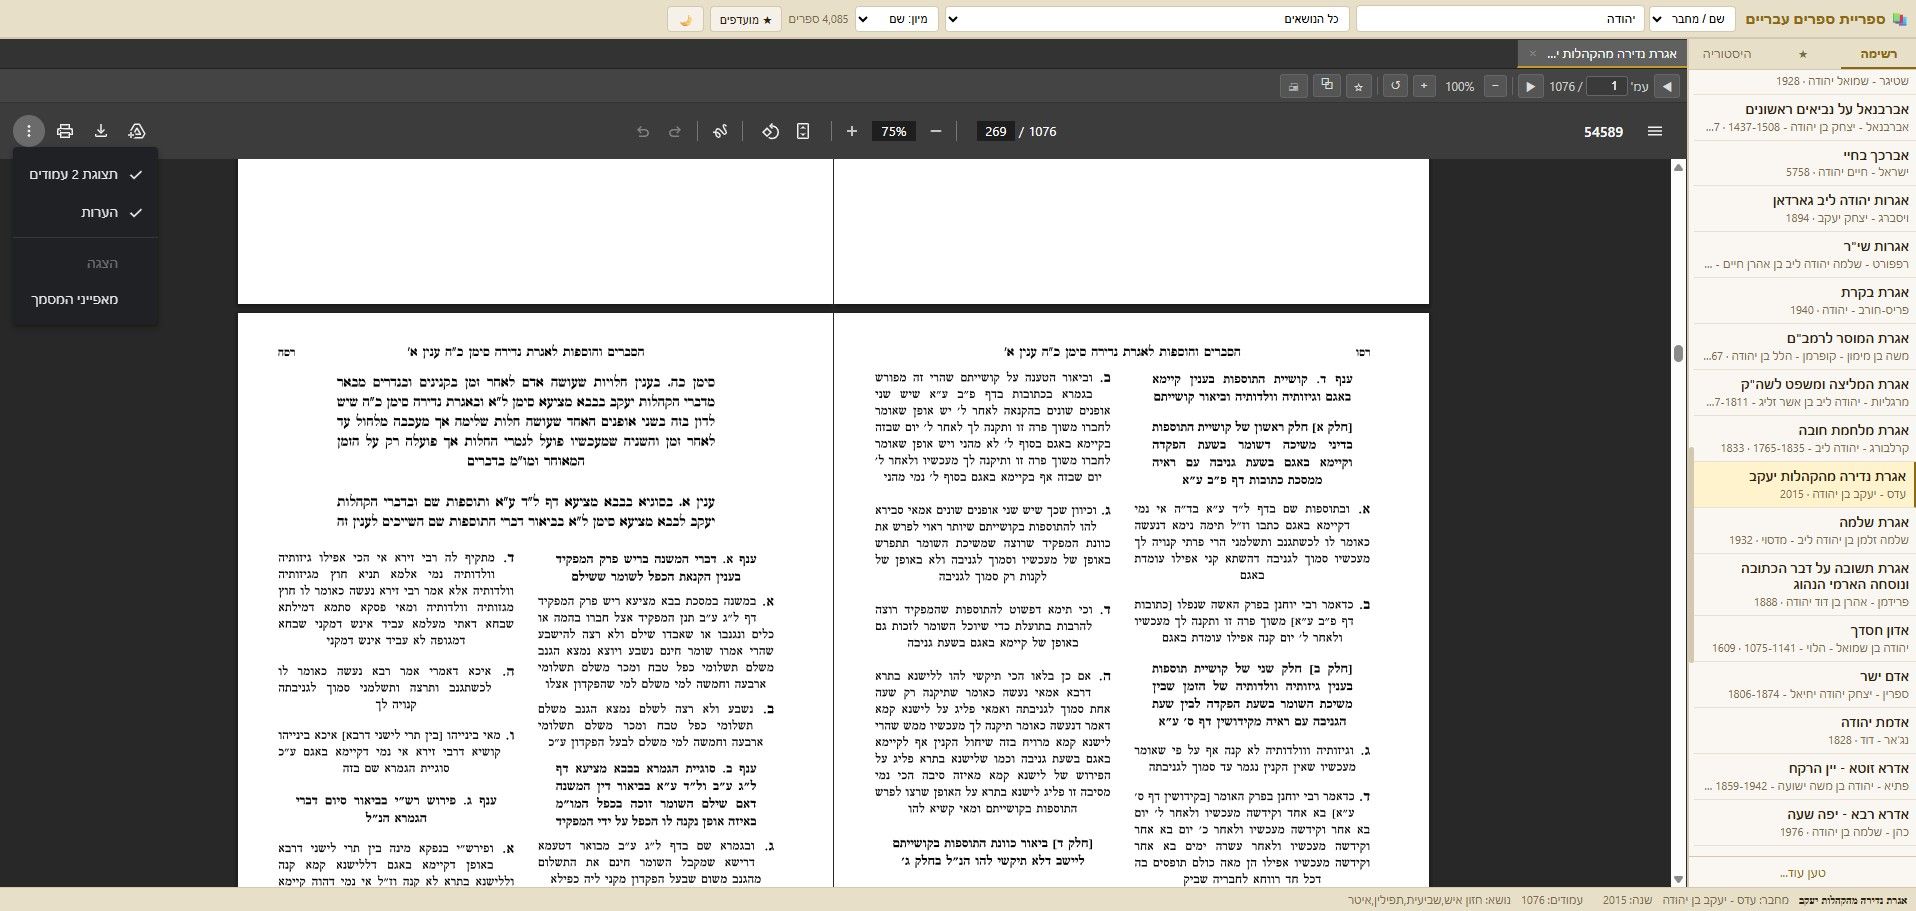
    e49daabc-4df9-463c-9758-cf2355cee06f-image.png

    ככה אני מדמיין את אוצריא בצורה יעילה.
    בצד ימין רשימת הספרים, ליד זה רשימת תגים להגיע מהר לכל ספר, לבצד שמאל התצוגה המלאה של הספר.
    חסר לי מאוד כפתור איפוס של הכל, להגיע למצב בסיס (כפי שהגדרתי אותו בגודל פונים ומצבים והכל, אבל שיסגור הכל לגמרי).
    לדעתי העניה, איתור וחיפוש ועיון והכל צריך לבוא במסך אחד דומה לתמונה ששלחתי, זה הרבה יותר נח והרבה יותר יעיל, וכך בכל התוכנות הקיימות, ולא לחלק למודולים שונים שכל אחד יש לו מצב צבירה שונה.


  • הצעת ייעול | אימון מודל לפיענוח טקסטים
    111 11
    הוספת ספרים לספריית אוצריא הצעה לפיתוח ocr הקלדה

    @ע-ה-דכו-ע כתב:

    @11 כתב:

    האפשרות הפשוטה ביותר לפי מה שאני יודע מניסיוני הדל, הוא לבנות משחק ילדים לבין הזמנים, שבו יאשרו צורת אותיות, וכל אות א' שתאושר תכנס למאגר בכל מקום שבו יש עד סטיית 4 פיקסלים.

    לאמן מודל על אותיות לבד זה עלול להיות בזבוז זמן.

    צריך לאמן על משפטים, כדי שיהיה הקשר

    בדיוק הפוך. לאמן על אותיות בחיזוק מילון.
    כלומר בערך כך: אם ניקח מילון של כל המילים, ונייצר מודל אימון שיציף לנו רק את המילים שאינן קיימות במילון, נקבל את התיקונים הכי טובים. זה מה שגוגל עשו, וחכמה בגויים תאמין.


  • באג | פרטי ספר שיש PDF
    111 11
    בעיות - תוכנת אוצריא באג pdf היברובוקס

    אנסה שוב.
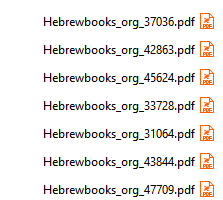
    כשאני מוריד לתיקיה של היברו בוקס את הקבצים הללו

    image.png
    וכך הם אצלי בתיקיה.
    התוכנה בכל אופן יודעת לזהות כשאני מחפש את הספר "מכתב גלוי" להציג לי את הספר מספר 33728.
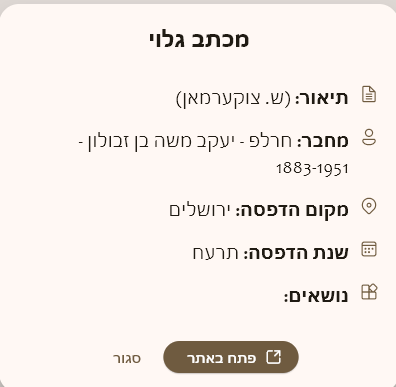
    מי לימד את אוצריא שהספר מכתב גלוי הוא מספר זה? האינדקס. אותו אינדקס שבו כתוב

    image.png

    ברגע שהכנסתי את הספר לתיקיה, בכל פעם שאני לוחץ על מכתב גלוי אני מגיע אוטומטית לקובץ PDF הזה.
    אבל, מאותו רגע אני כבר לא רואה את הפרטים של הספר.


  • הצעת ייעול | כמה שיפורים שאני ממליץ בחום רב
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח עיצוב ניווט חיפוש

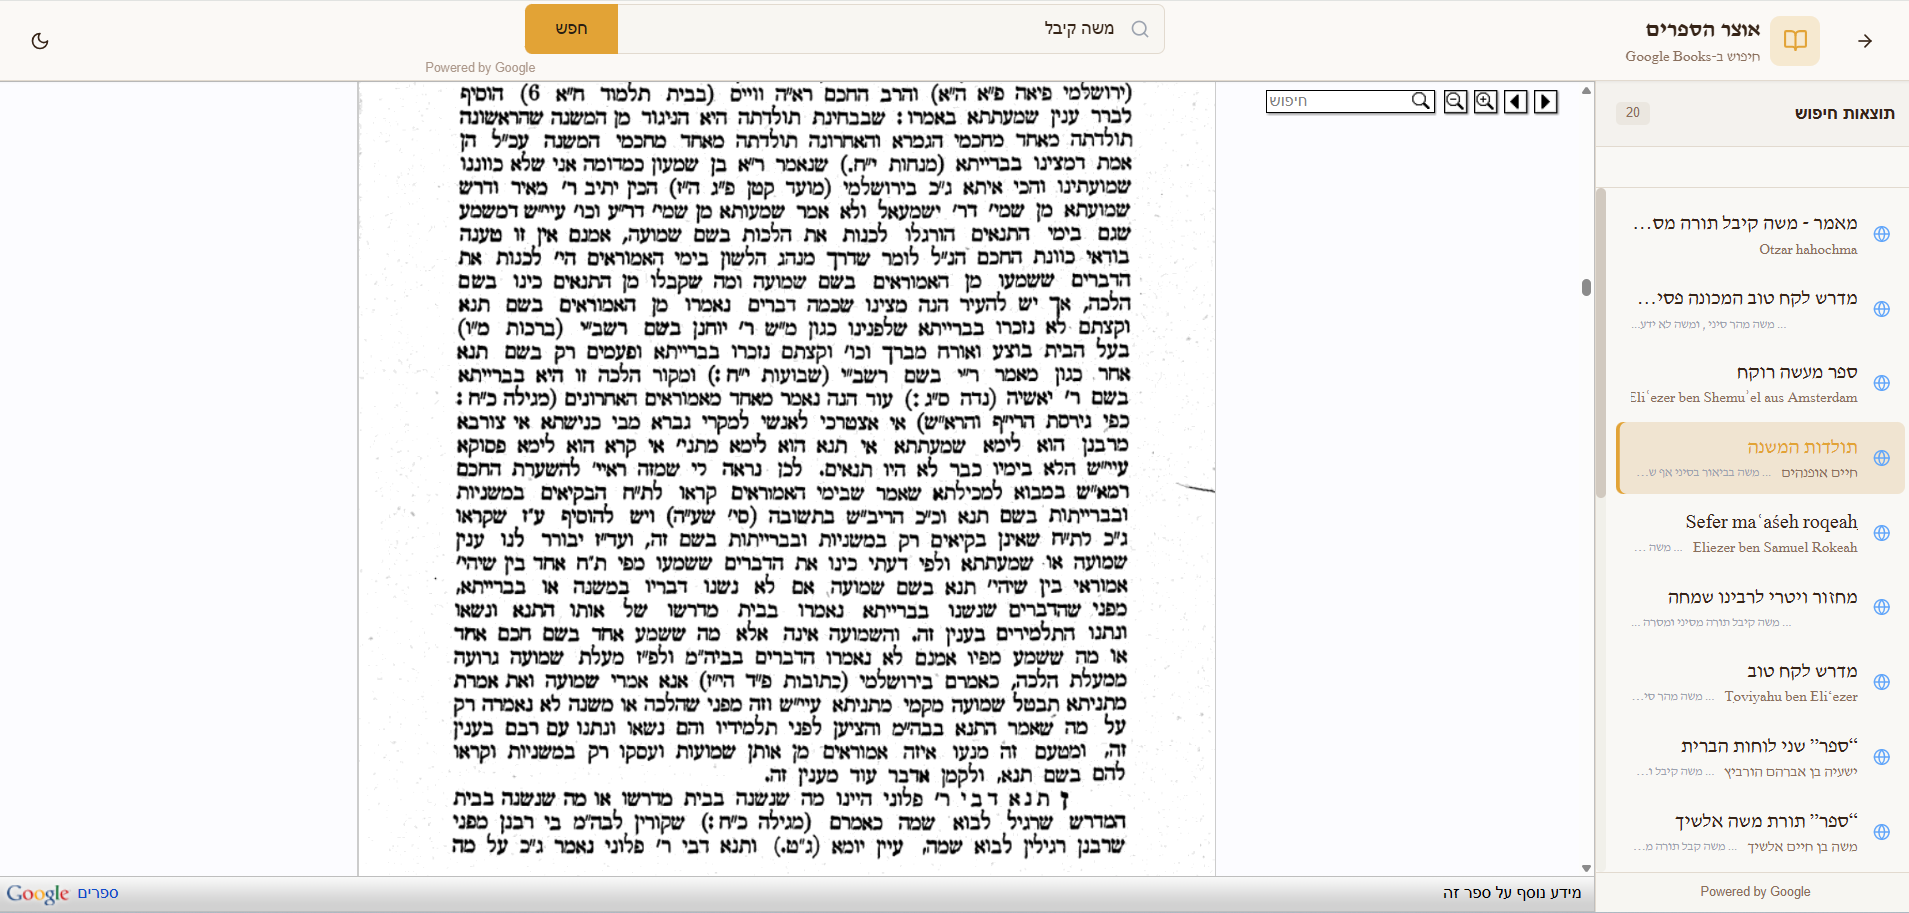
    עוד משהו שאפשר רק באתר, חיפוש דומה לאוצר החכמה בספרי גוגלבוקס

    image.png


  • בירור | ספרים מגוגל בוקס (Google Books)
    111 11
    הוספת ספרים לספריית אוצריא הוספת ספרים בירור רשימת-ספרים api נטפרי

    @דנדי כתב:
    [לי אין קלוד]

    יש במשנת יוסף 2 ב-10.


  • באג | פרטי ספר שיש PDF
    111 11
    בעיות - תוכנת אוצריא באג pdf היברובוקס

    @י.-פל. כתב בבאג | פרטי ספר שיש PDF:

    @arieldaniely כתב בבאג | פרטי ספר שיש PDF:

    יש צפי להחזרה?

    כן.

    תן לנו רמז קטן. אפשר באתב"ש.


  • הצעת ייעול | כמה שיפורים שאני ממליץ בחום רב
    111 11
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח עיצוב ניווט חיפוש

    עוד דבר לשיפור חשוב מאוד:
    בקישור ספרים להיברו בוקס, לא להכניס קישור לעמוד הבית של הספר, אלא לעמוד הראשון של הספר בקריאה מקוונת. לחשוב לכל משתמש את המעבר הנוסף המיותר עבורו.


  • הצעת ייעול | הגהה של ספרים באתר
    111 11
    אתר העריכה 'ספריית אוצריא' הצעה לפיתוח ספריית אוצריא ocr עריכת ספרים

    @דוד-משה-1 כתב בהצעת ייעול | הגהה של ספרים באתר:

    אני אם הייתי מעלה לבינה זה אחרי OCR כלומר לעשות OCR ולהעלות לו תמונה ואת התוצאה

    הידע של ג'מיני לבצע OCR הוא עצום ביחס לתוכנות הישנות. כי הוא מזהה לכלולכים בדף וצורת הדף ולא רק מבנה אותיות.
    אחר כך הוא מזהה מבנה של אותיות.
    ורק בשלב השלישי הוא מתקן לפי דעתו הקלושה. אם תגדיר שהוא יעבוד לפי הסדר הזה בדיוק, תקבל תוצאות מקסימליות (ל-2026. בעוד שנה יהיה כבר יותר טוב)

  • התחברות

  • אין לך חשבון עדיין? הרשמה

  • התחברו או הירשמו כדי לחפש.
  • פוסט ראשון
    פוסט אחרון