דילוג לתוכן
0
  • דף הבית
  • חוקי הפורום
  • מדריכים
  • פוסטים אחרונים
  • לא נפתר
  • תגיות
  • פופולרי
  • משתמשים
  • תרומות לאוצריא
  • צור קשר
  • דף הבית
  • חוקי הפורום
  • מדריכים
  • פוסטים אחרונים
  • לא נפתר
  • תגיות
  • פופולרי
  • משתמשים
  • תרומות לאוצריא
  • צור קשר
עיצובים
  • בהיר
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • כהה
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • ברירת מחדל (ללא עיצוב (ברירת מחדל))
  • ללא עיצוב (ברירת מחדל)
כיווץ
לוגו אתר

פורום אוצריא

אוצריא - דף הבית
|
קח שותפות בהוספת ספרים
|
תרום לאוצריא
מיכאלושמ

מיכאלוש

@מיכאלוש
הפסקת מעקב מעקב
אודות
פוסטים
286
נושאים
15
שיתופים
0
קבוצות
1
עוקבים
1
עוקב אחרי
0

פוסטים

פוסטים אחרונים הגבוה ביותר שנוי במחלוקת

  • להורדה | תוסף בר אילן לאוצריא
    מיכאלושמ מיכאלוש
    תוספים לאוצריא - פרסום תוספים בר אילן הורדה התקנה github

    תוסף בר אילן לאוצריא

    קישור קבוע להורדת גרסת המתקין האחרונה כולל גם את היישום רקע וגם את התוסף

    קישור לחנות (צריך להתקין בנפרד את היישום רקע)

    שרשור התגובות

    בר אילן לאוצריא – בקצרה

    התוסף מחבר בין אוצריא לבין פרויקט השו"ת של בר אילן המותקן במחשב.

    מה אפשר לעשות איתו?

    • לחפש מתוך אוצריא ספרים שנמצאים בבר אילן, לפי ספר או מחבר, ולפתוח אותם בלחיצה.
    • לעיין בקטגוריות וברשימת ספרי בר אילן מתוך אוצריא.
    • לבצע חיפוש בטקסט בבר אילן – חיפוש רגיל, מתקדם או בניסוח חופשי.
    • לכתוב מקור, כגון ברכות דף ב עמוד א, ולפתוח את בר אילן ישירות במקום המתאים.
    • לסמן טקסט בספר באוצריא ולשלוח אותו לחיפוש בבר אילן בלחיצה ימנית.
    • לפתוח בבר אילן את המקום שבו נמצאים כרגע בספר באוצריא.
    • להציג את ספרי בר אילן גם בחיפוש הספרים הרגיל של אוצריא.

    מה התוסף לא עושה?

    • הוא לא מעתיק את ספרי בר אילן לאוצריא ולא מייבא את הטקסטים שלהם.
    • תוצאות החיפוש והספר עצמו נפתחים בתוכנת בר אילן.
    • הוא אינו עוקף רישיון או מנגנון הגנה, ודורש התקנה חוקית של פרויקט השו"ת במחשב.

    בקיצור: המטרה של התוסף היא לא להחליף את בר אילן, אלא לאפשר לעבוד מאוצריא ולקפוץ לבר אילן בדיוק כשצריך, בלי לעבור ידנית בין שתי התוכנות.

    הבהרה חשובה:

    שימו לב התוסף עדיין בגרסת בטא ויש עוד באגים אין לי איך לבדוק אותו על יותר מ 10 גרסאות שונות שמצויות בשוק באם נתקלתם בבאג כלשהוא עדיף לשלוח מיד דיווח דרך לשונית אודות ודיווח זה שולח אלי גם את הלוגים וכך יותר קל לעלות על מקור התקלה
    באם אחרי עדכון גרסא עדיין לא נפתר ניתן לשלוח שוב


  • הצעת ייעול | הוספת קישור ישיר לספר
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח קישור ישיר וורד

    @מענין-לשמוע כתב בהצעת ייעול | הוספת קישור ישיר לספר:

    @מיכאלוש
    ראיתי שביצעת את זה!!
    נשמח שתסביר יותר מה זה אומר
    גם אם התוכנה סגורה?

    @מענין-לשמוע
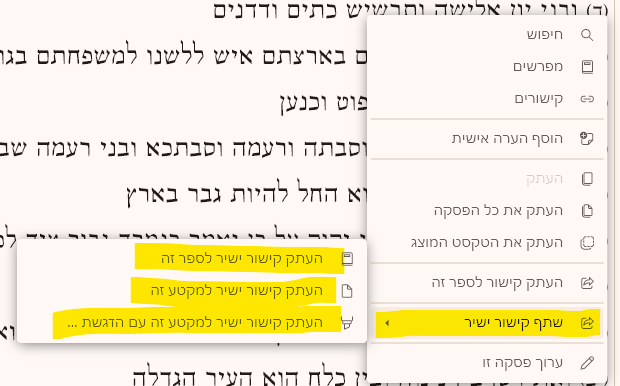
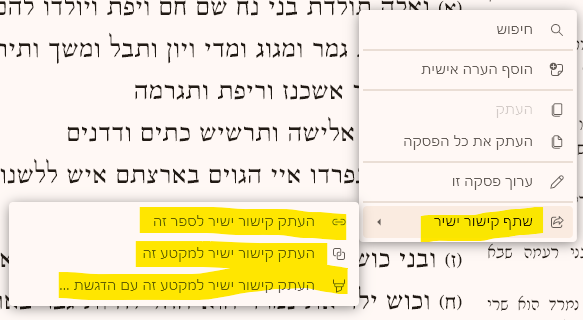
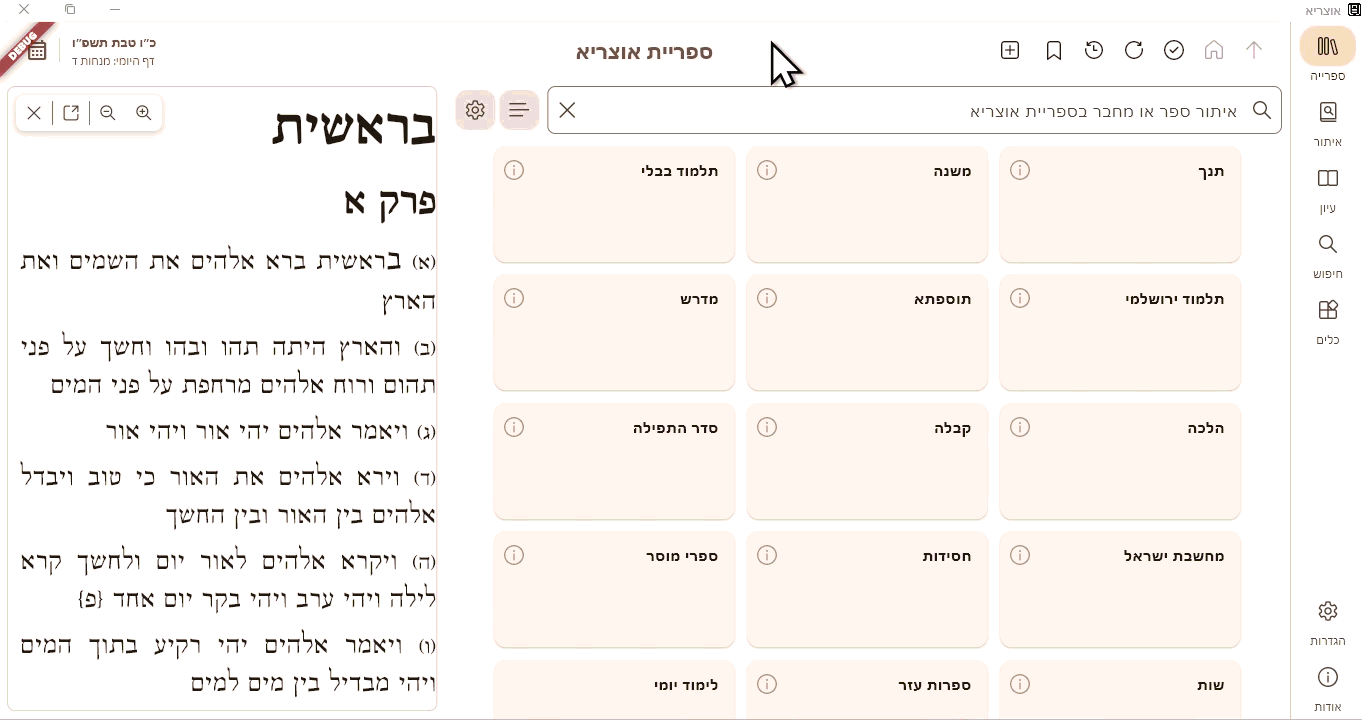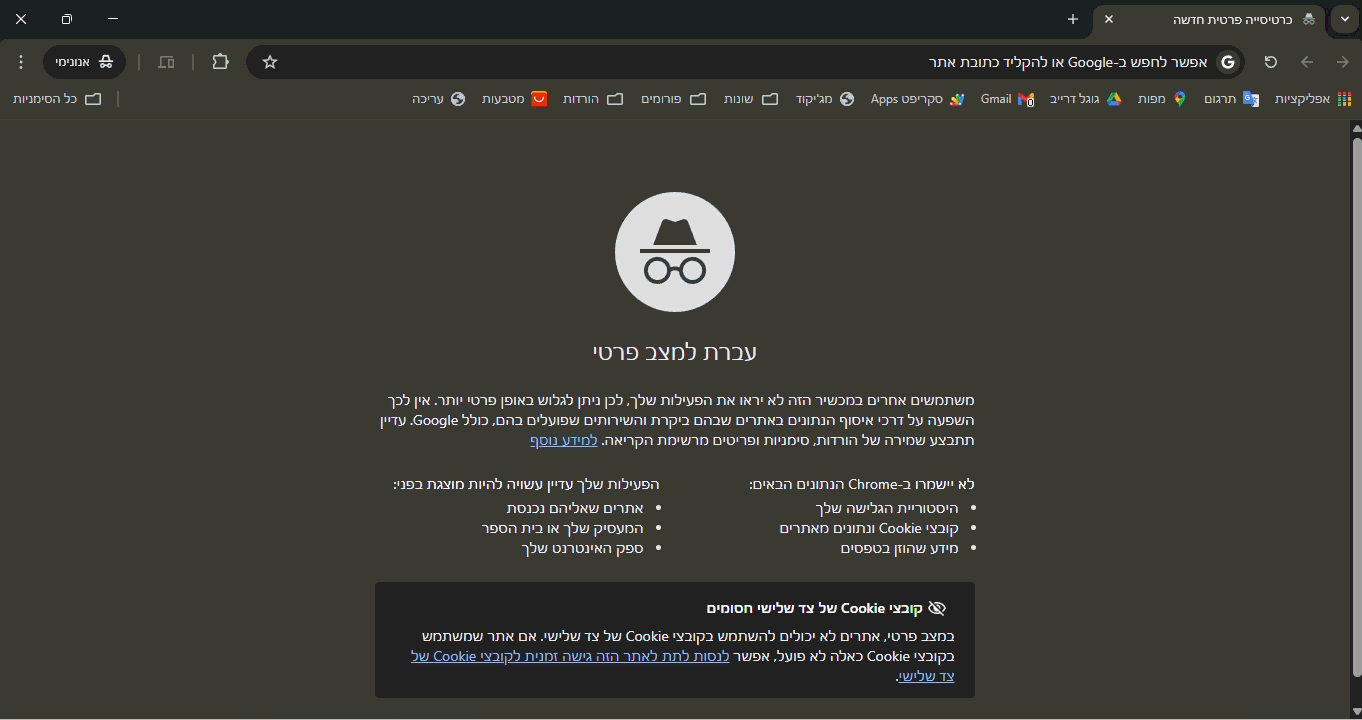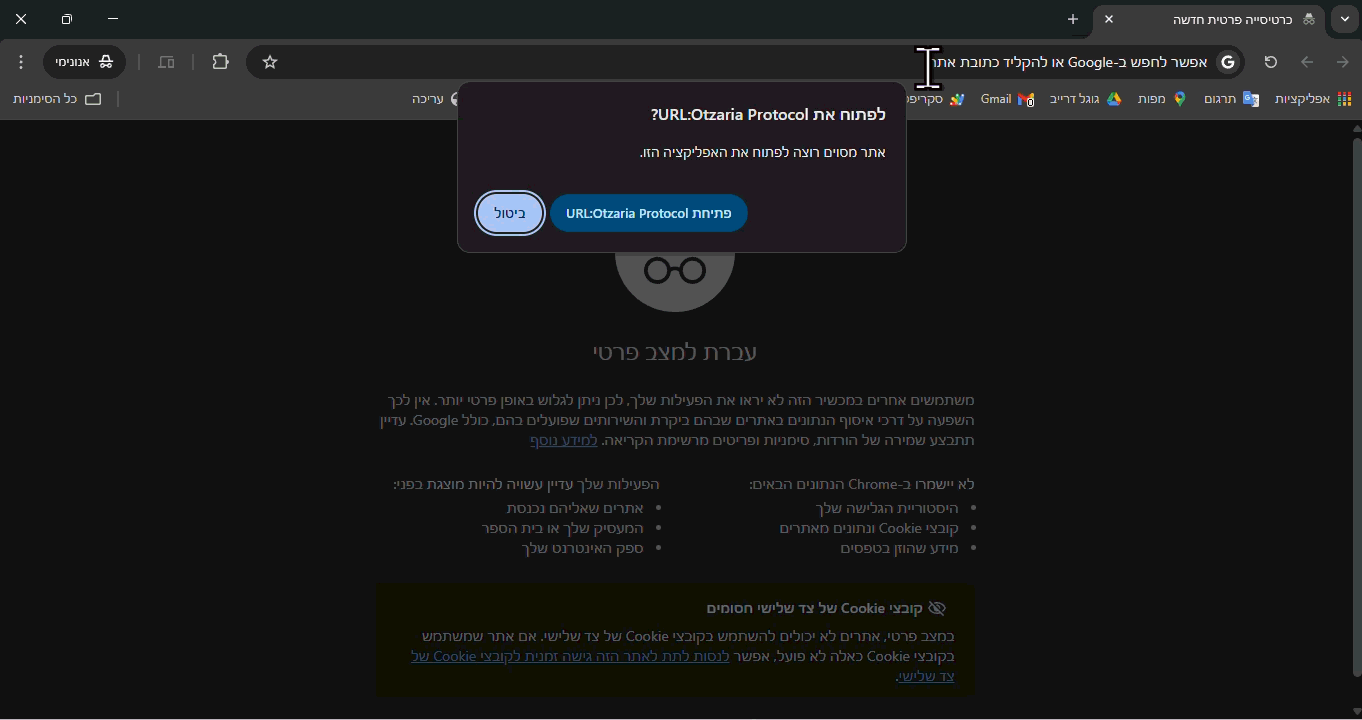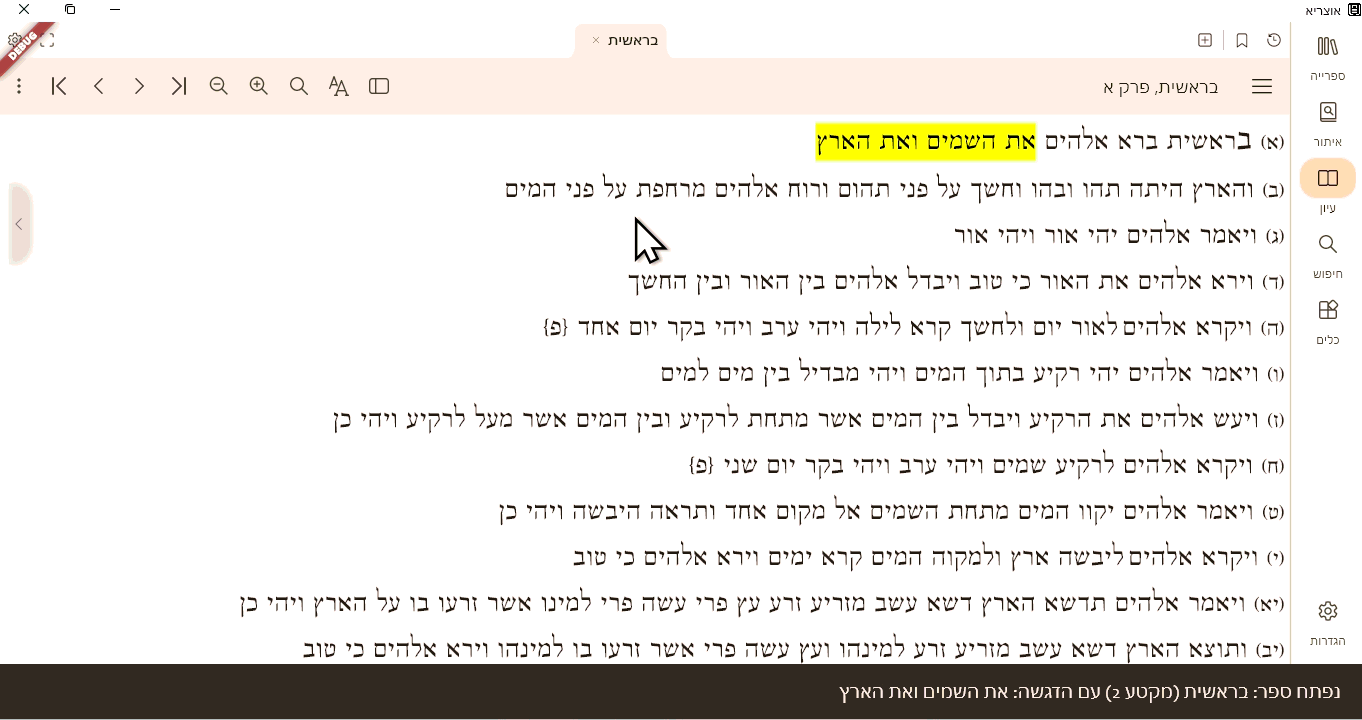
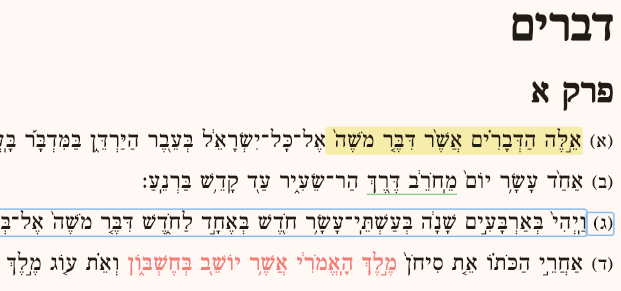
    זה אומר שנוספה פונקציה חדשה בתוכנה לפתיחה של כרטיסייה חדשה ישירות לספר או דף/מקטע מסוים בספר, כולל אפשרות להדגיש טקסט מסוים.
    האפשרות החדשה עובדת גם כשהתוכנה פתוחה וגם כשסגורה.

    מבנה הקישורים:

    פתיחת ספר טקסט רגיל

    otzaria://book/בראשית
    

    פתיחת ספר רגיל במקטע מסוים

    otzaria://book/בראשית?index=206
    

    פתיחת ספר רגיל במקטע מסוים עם הדגשת בטקסט מסוים

    otzaria://book/בראשית?index=352&text=ויהי בימי אמרפל
    

    פתיחת ספר רגיל במקטע מסוים כולל הדגשת הטקסט בכל המקטע

    otzaria://book/בראשית?index=3&text=true
    

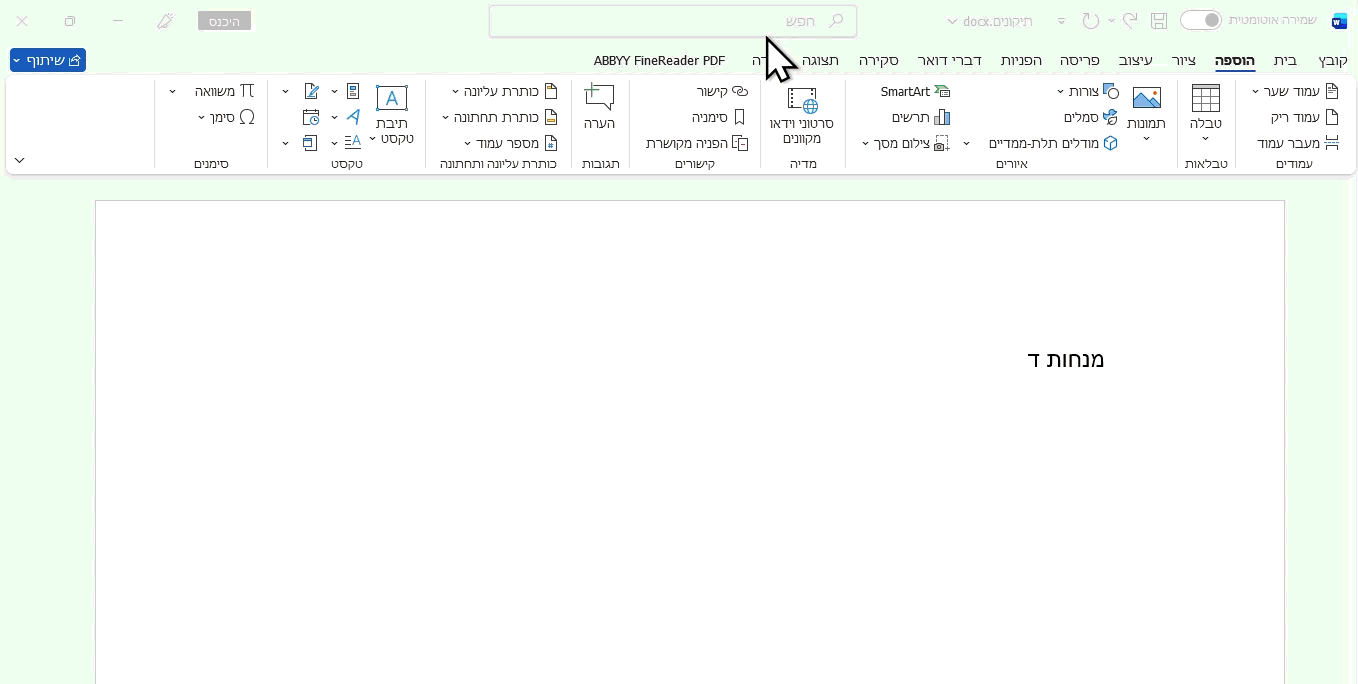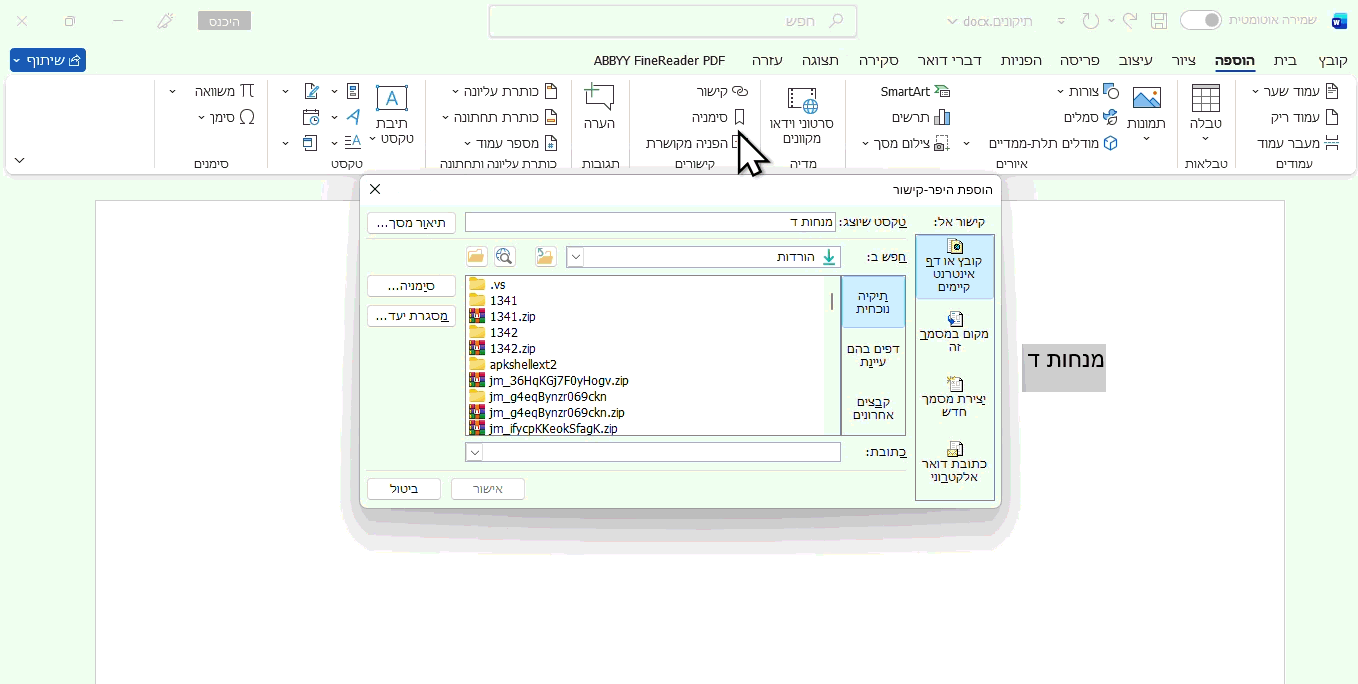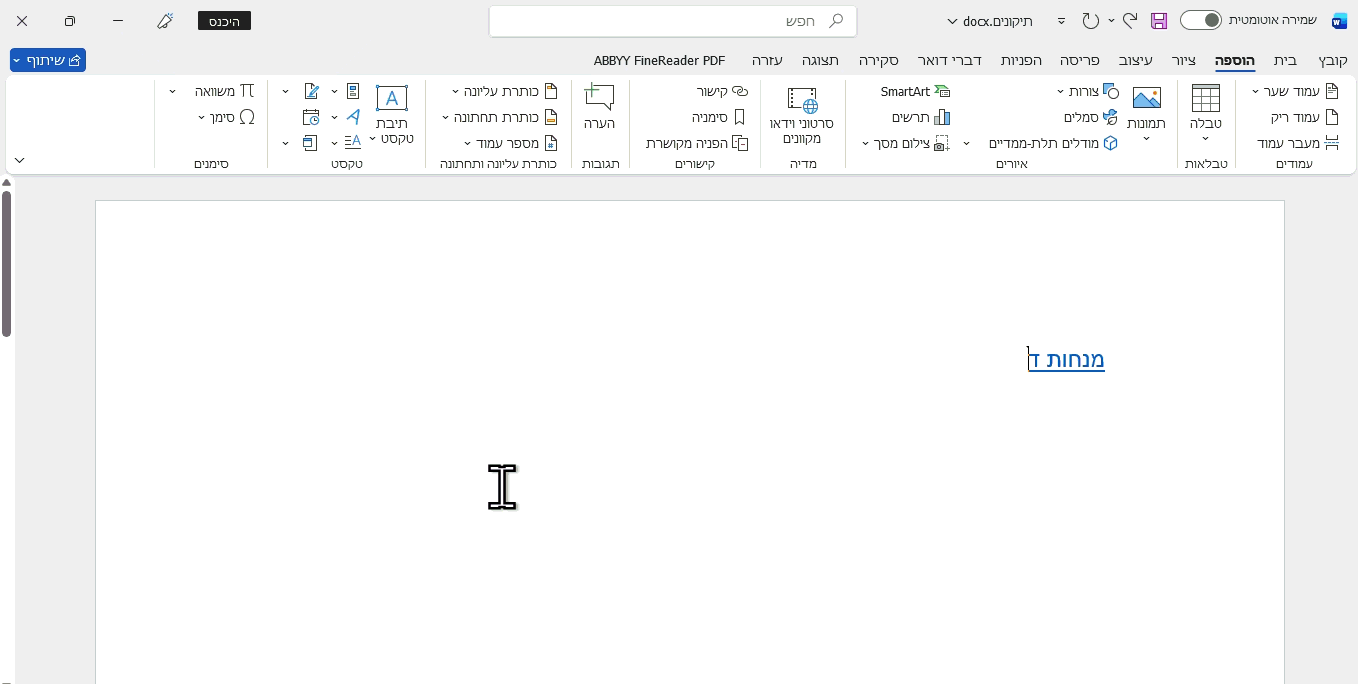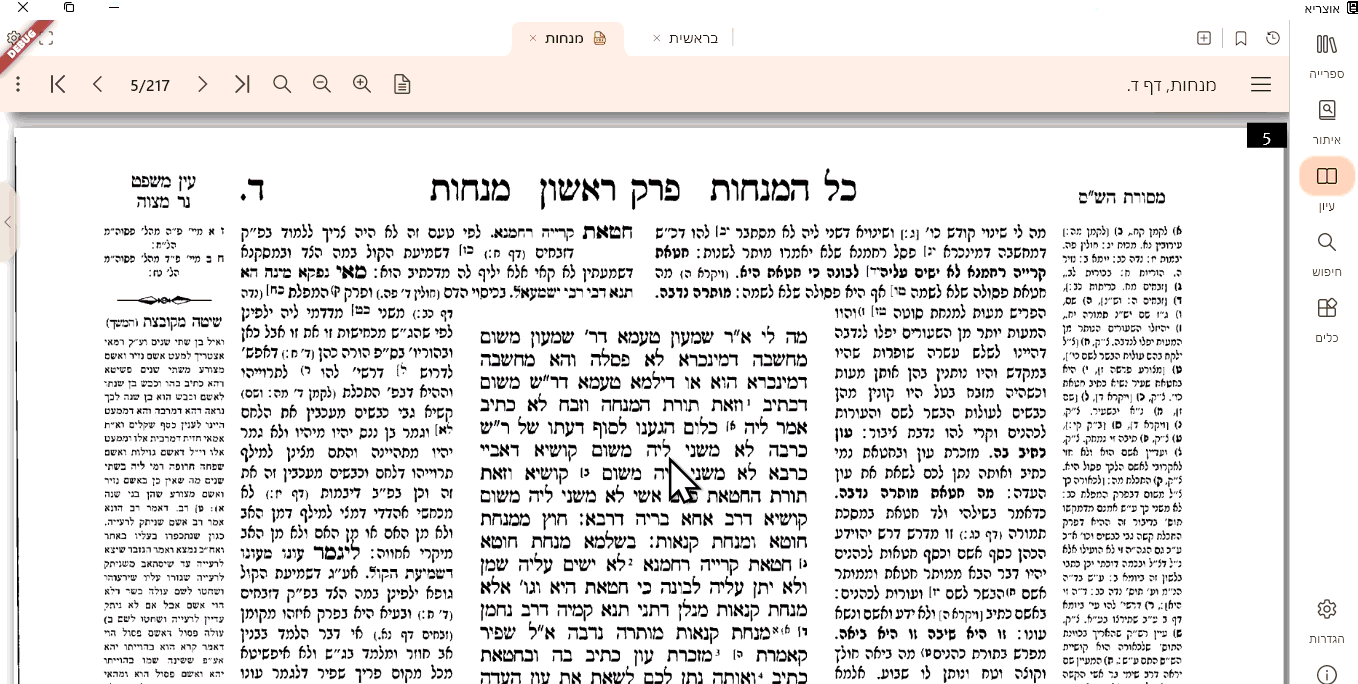
    פתיחת ספר PDF

    otzaria://pdf/מנחות
    

    פתיחת דף מסוים ב PDF

    otzaria://pdf/מנחות?page=5
    

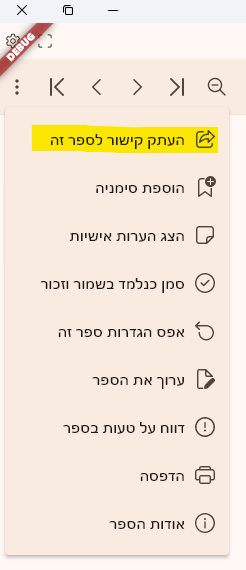
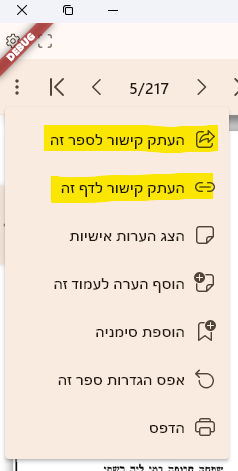
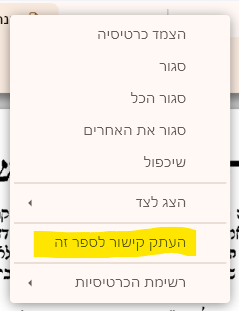
    כמובן נוספה האפשרות להעתיק את הקישורים בתפריטים השונים

    a0753596-4b6e-4cb8-96c0-bc2e2d96bca4-image.png

    a5a71cb7-e732-449a-96ae-ce98ee2d95dc-image.png

    ebb2735d-0499-4103-a75c-27c5bb49e594-image.png

    5e1f66f6-82ac-4a02-9e9e-94727baf17a0-image.png

    8f5ce4cf-2d1c-43f7-b071-6979e6d739ff-image.png

    222.gif

    הדגמה.gif

    @מענין-לשמוע כתב בהצעת ייעול | הוספת קישור ישיר לספר:

    ואם תוכל לבנות את זה לגירסא ולהביא קישור להורדה...

    לא יודע איך עושים את זה וגם לא רואה עניין, מקווה שישולב בגרסאות הרגילות של @י.פל


  • בקשה | מי שיוכל להקליד את העמוד הזה ולהעלות כאן את הטקסט שלו אשמח מאוד
    מיכאלושמ מיכאלוש
    הוספת ספרים לספריית אוצריא הוספת ספרים הקלדה pdf

    @יום-חדש-מתחיל

    הנה הטקסט המוקלד מתוך הדף, כתוב באותיות רגילות (במקום כתב רש"י המופיע במקור):

    וילקט מערכת א יוסף

    אחר תאות עוה"ז ושנים אמצעיות אין בהם כ"כ תאוות עוה"ז ושני הזקנה אין לו תאות כלל וטעם לזה לפי שג' שותפין באדם אב ואם והקב"ה לכן בשני נערות יש לו להאדם תאוות רבות מצד חלק האם שיש בו ובשנים אמצעיות אין בו תאוות כ"כ לפי שכבר כלה חלק האם שבו אבל עכ"ז יש לו תאות מצד חלק האב שבו אבל בימי הזקנה אין לו תאות כלל לפי שהוא חלק הקב"ה
    (ס' ליקוטי יקרים):

    לא אלול
    דע דיום שבת קדש כלול כל יומי דחול ומניה מתברכין כל שית יומין עילאין כדאיתא בזוה"ק
    פ' יתרו כמו כן זה החדש כולל כל חדשי השנה ומרומז בתורה שכל י"ב חדשים המה כנגד י"ב שבטי ישראל והחדש אלול הוא בסוד היסוד שהוא בסוד ברית קודש ויוסף בגין דנטר בריתו דרגא דיליה יסוד ע"ד נק' צדיק כידוע וכללו של דבר שהחדש
    אלול הוא בסוד יוסף הצדיק ויוסף היה מכלכל את אחיו כמו כן כל החדשים מצפים שיזונו ויפרנסו ויהיה להם תקומה מזה החדש שהוא בסוד יוסף (שער המלך):

    לב אלול
    י"ג מידות הם והם כנגד י"ב חדשים מדת אל הוא
    ניסן רחום כנגד אייר וחנון נגד סיון ארך נגד תמוז אפים נגד אב ורב חסד נגד אלול ואלול הוא החדש הששי ששה קנים מצד האחד וששה קנים מצד השני ואם אנו עושים תשובה בזה החדש הוא המחצה מן החדשים אמרו שפיר בית
    הלל רב חסד שהוא אלול מטה כלפי חסד שהוא ניסן ר"ל מכריע כף מאזנים נוצר חסד שמצא מין את מינו מדת ורב חסד מטה


  • שיתוף | מקשר הערות אוטומטי
    מיכאלושמ מיכאלוש
    מדריכים ותוכנות עזר לאוצריא תוכנות עזר הערות וורד

    עדכון אב תשפו התוכנה שופרה משמעותית ועודכנה לפי התיעוד החדש
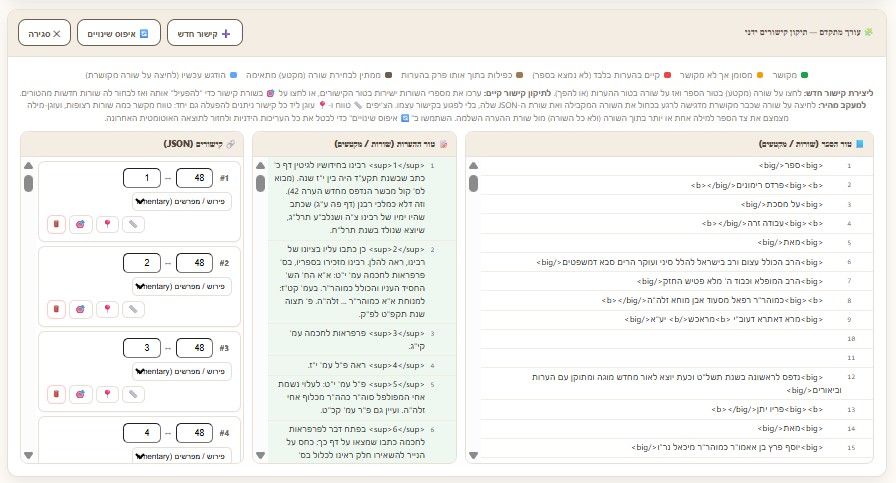
    מאפשר עכשיו לקשר לפי שורה, מילה, או כמה מקטעים כולל אופצייה נוחה להצגה עריכה ידנית וכו'
    פשוט תכנסו ותנסו

    כניסה לתוכנה

    6961bb17-34a5-4252-9cf7-542a95ae7f23-image.jpeg

    d63917c8-9b98-4213-9b6f-fc12cdc73ce6-image.jpeg

    5c49232e-b9be-4014-8138-13cd36338b50-image.jpeg

    58a0af42-ed64-42c0-b83c-7b0f559e3d56-image.jpeg


  • להורדה | תוסף מרקר
    מיכאלושמ מיכאלוש
    תוספים לאוצריא - פרסום תוספים מרקר

    תוסף מרקר

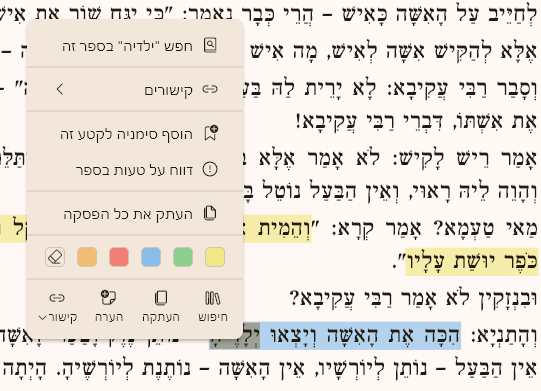
    סימון טקסט בצבעים מתפריט מקש ימני וניהול כל ההדגשות בצורה נוחה במקום אחד.

    הורדה והתקנה מהחנות

    הורדה מהפורום
    com.otzaria-marker-0.9.0.otzplugin

    תמונות בספויילר:


    c3d0de60-4801-42ce-958d-2bdb67fbbb83.png

    צילום מסך 2026-07-22 090023.png

    צילום מסך 2026-07-15 222636.png


  • עדכון | קישורים - תצוגה מקדימה
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא עדכון קישור עיצוב

    @י.-פל.
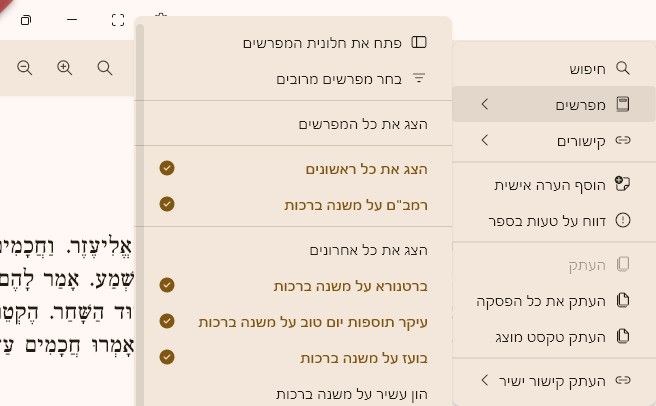
    אם כבר אז למה לא להוסיף אותו דבר גם למפרשים
    6ec8588a-de85-4d4e-8b80-ffae990f343a-image.jpeg


  • להורדה | תוכנה ליצירת ועריכת קישורים ומפרשים באוצריא בקלות
    מיכאלושמ מיכאלוש
    מדריכים ותוכנות עזר לאוצריא תוכנות עזר מדריך מפרשים

    עדכון:

    לאחר ש @יהודי-צעיר הודיע שאין זמנו בידו להתאים את התוכנה לDB ולמבנה הקישורים החדש
    הוצאתי עדכון לתוכנה

    ניתן להוריד לעבודה אופליין
    מנהל המפרשים והקישורים החדש.tar
    או לעבוד אונליין
    https://otzaria.github.io/OtzariaLinker/

    שימו לב ניתן לכתוב כאן בשמחה הערות, הצעות, באגים וכו' אבל אני לא מתחייב לתחזק את התוכנה הכל בקוד פתוח אולי מישהוא אחר יתנדב לקחת חסות לשפר ולשדרג

    https://github.com/Otzaria/OtzariaLinker/


  • עזרה | הערות על תוסף תיקון קוראים
    מיכאלושמ מיכאלוש
    תוספים לאוצריא - דיונים תוספים תיקון קוראים גופן ניקוד עליות

    הרב @פלמנמוני היקר התוסף ממש מיוחד כמה הערות קטנות:

    • דבר ראשון ברוב התיקון קוראים הטור ניקוד בימין והטור סתם בשמאל

    • בגופן סתם תגדיר ברירת מחדל את קלאסי (זה מה שיש בוינדוס)
      נ.ב. עכשיו הוא לא מוצג עקב שגיאת תחביר כנראה במהלך בשינוי שם שעשיתי לו...

    • הייתי מאפשר להוסיף ולהציג מגופני המערכת גם בגופן ניקוד וגם בגופן סתם

    • עליות יותר מתאים ראשון שני שלישי או כהן לוי שלישי מאשר עליה א

    • כדאי להוסיף אופציה להסתרת שם השם

    • הקווים בין השורות הייתי שוקל להסיר או לפחות לאפשר בהגדרות להסיר

    • אולי כדאי להוסיף יתרות וחסרות בצד כמו שמקובל בתיקון סופרים שת (שורה תמימה) יא (יתר אחת) חא (חסר אחת ) וכו'

    • הבאג היחיד שנתקלתי זה בקריאות שלא טוען את התוכן כל השאר זה רק הצעות לשיפור שחלק גדול מהם אני אשם...


  • הצעת ייעול | הצעה לאופציה חדשה 'רפרוף' (או, אם יחליטו המפתחים שלא, הצעה לתוסף חדש 'רפרוף')
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח ייעול טאבים תוספים סביבת-עבודה

    @pcinfogmach כתב:

    לכאורה התיקון הנדרש הוא להוסיף אופציה לפתיחת חלונות מרובים (אם אין אופצה כזו).

    בעבודה ממזמן כולל גרירת חלונות ועוד מקווה שיגמר לפני הגרסא הקרובה...


  • עזרה | הערות על תוסף תיקון קוראים
    מיכאלושמ מיכאלוש
    תוספים לאוצריא - דיונים תוספים תיקון קוראים גופן ניקוד עליות

    @יאיר-דניאל

    תמונה לתוסף

    תמונה לתוסף.png


  • באג | באגים בגרסת 0.94
    מיכאלושמ מיכאלוש
    בעיות - תוכנת אוצריא באג התקנה תוכנת אוצריא

    @מחצית היה באג מסויים שמנע מהID של הספר להיטען כשהספר לא נפתח דרך מסך ספרייה אלא נפתח דרך מפרשים קישורים וכו' והוא תוקן כבר בקומיט שמוזג היום יופיע בגרסא הבאה


  • בירור | ספרים מגוגל בוקס (Google Books)
    מיכאלושמ מיכאלוש
    הוספת ספרים לספריית אוצריא הוספת ספרים בירור רשימת-ספרים api נטפרי

    @יום-חדש-מתחיל כתב לפני חודש

    לאחרונה התגלה לי שיש הרבה ספרים שלא נמצאים בהיברובוקס, אבל נמצאים באתר של ספרים של > גוגל, בכתובת הזו: https://books.google.com/
    דא עקא, שהאתר הזה סגור בנטפרי (באתרוג הוא פתוח). ניתן לבקש מהם לפתוח כתובות ספציפיות של ספרים.

    כיוון שגם לי חסום גוגל בוקס ואין לי מושג אפילו איך נראה האתר שם (אני מבין שזה רק ספרים סרוקים, נכון?) שלפתי את רשימת הספרים שעלולים להיות רלוונטים דרך הAPI הרשמי של הספרייה הלאומית (יתכן ויש עוד ספרים שעלולים להיות רלוונטים בגוגל בוקס אבל לא מופיעים ברשימות הספריה הלאומית)

    ראשית הורדתי רשימה ענקית של הספרים בעברית בספרייה הלאומית 116,400 במספר (אלק בספרייה רובם באוצר החכמה, היברבוקס, גוגל בוקס, וכו')

    אם מעניין מישהוא להלן הרשימה:
    ספרים בעברית בספריה הלאומית.xlsx

    לאחמ"כ מיינתי לקובץ קטן יותר את כל הספרים שמופיעים גם בגוגל בוקס 12,160
    זה עדיין כולל ספרים שנמצאים גם בגוגל בוקס וגם היברבוקס וכו'
    וזה כולל גם הרבה ספרי חול ועיתונים, ספרי חיצוניים ודעות כוזבות וכו'

    להלן הרשימה
    ספרים בעברית בספרייה הלאומית מגוגלבוקס.xlsx

    שלב הבא צריך להמשיך למיין ולסנן להעיף את כמויות הזבל ולסנן ע"פ שאר הפרמטרים כמו שנת הוצאה וזכויות שימוש וכו' וכמובן מה שכבר קיים באוצריא.

    למישהוא יש רעיונות, הערות, השגות וכו' ?

    מקווה שהמשך יבוא ...


    עדכון
    הוספתי לקובץ אקסל עמודה של סיווג זכויות יוצרים עם 2 פרמטרים: נחלת הכלל (3916 ספרים) / גוגל בוקס (4905 ספרים) ומחקתי את הספרים שהיה כתוב אליהם במפורש שאסורים בהעתקה (1410 ספרים) ומחקתי עוד 1957 ספרים של מבקר המדינה סה"כ 8823 ספרים לעבור עליהם ולסנן (שמתוכם 1970 עם כרכי עיתון המצפה)

    מצו"ב הקובץ העדכני עם רשימת 8823 הספרים

    ספרים בעברית בספרייה הלאומית מגוגלבוקס עם סיווג זכויות.xlsx

    מה לגבי עיתון המצפה, למחוק או להשאיר ?
    מה הלאה למישהוא יש רעיון ?
    להתחיל לעבור ידני ולסנן ?


  • שיתוף | מקשר הערות אוטומטי
    מיכאלושמ מיכאלוש
    מדריכים ותוכנות עזר לאוצריא תוכנות עזר הערות וורד

    מקשר הערות אוטומטי

    דבר ראשון אני חייב לציין לפני שמתחילים שהכלי הבא לא מתיימר, לא אמור, וגם לא יכול להחליף כלים אחרים.
    הכלי הבא נועד לצורך מאוד מסויים שאותו הוא מבצע בהצלחה מרובה ב"ה.

    ובכן למה כן מיועדת התוכנה ?
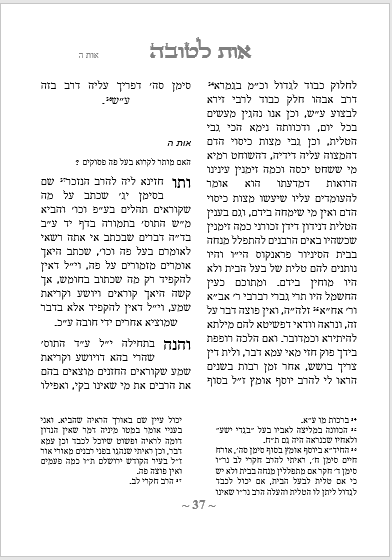
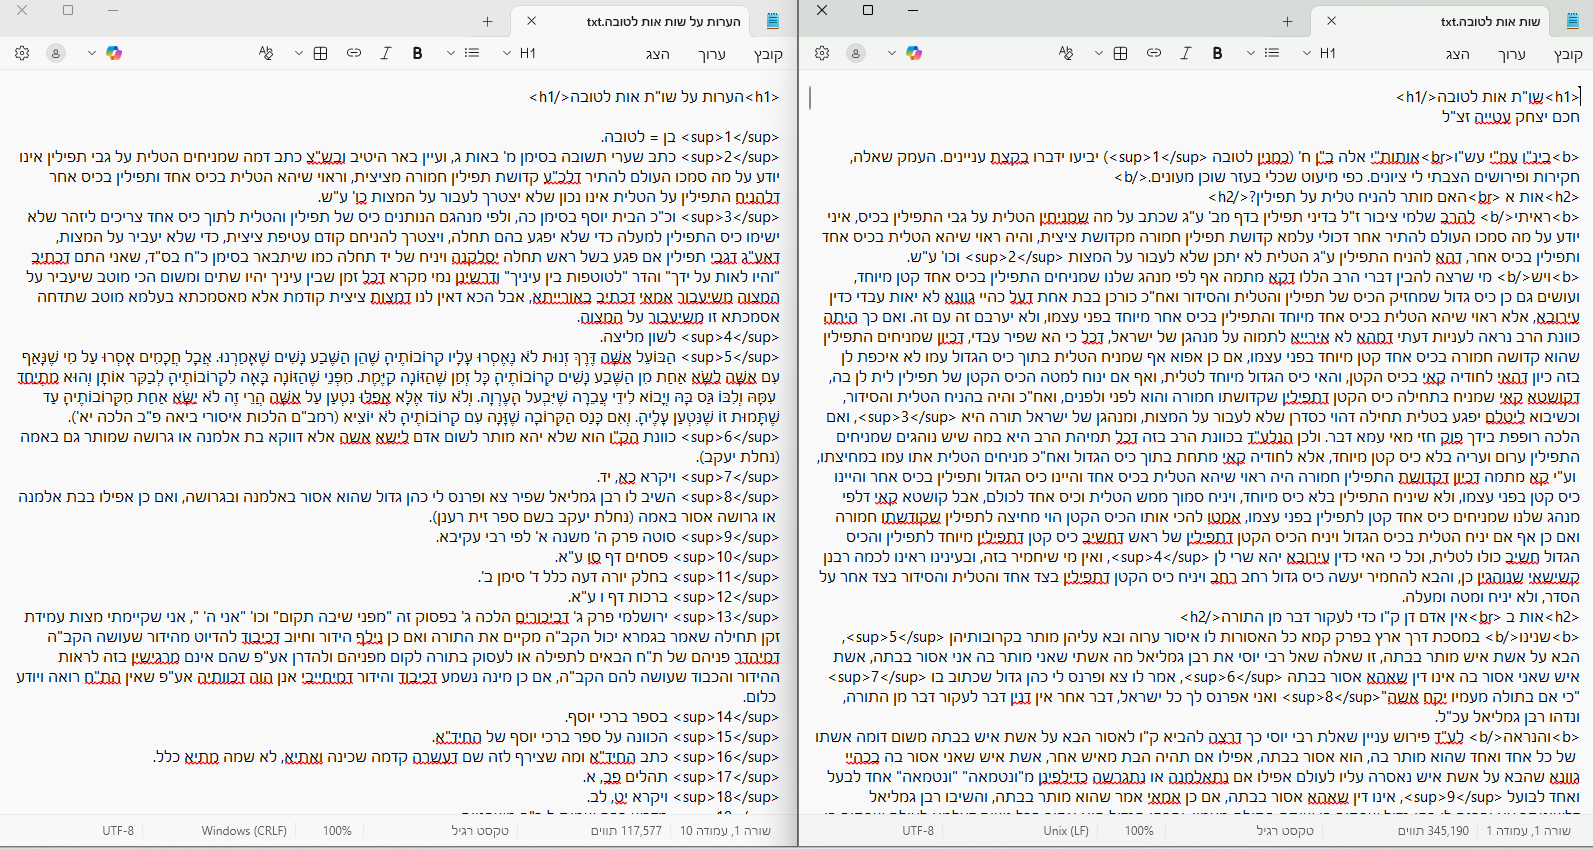
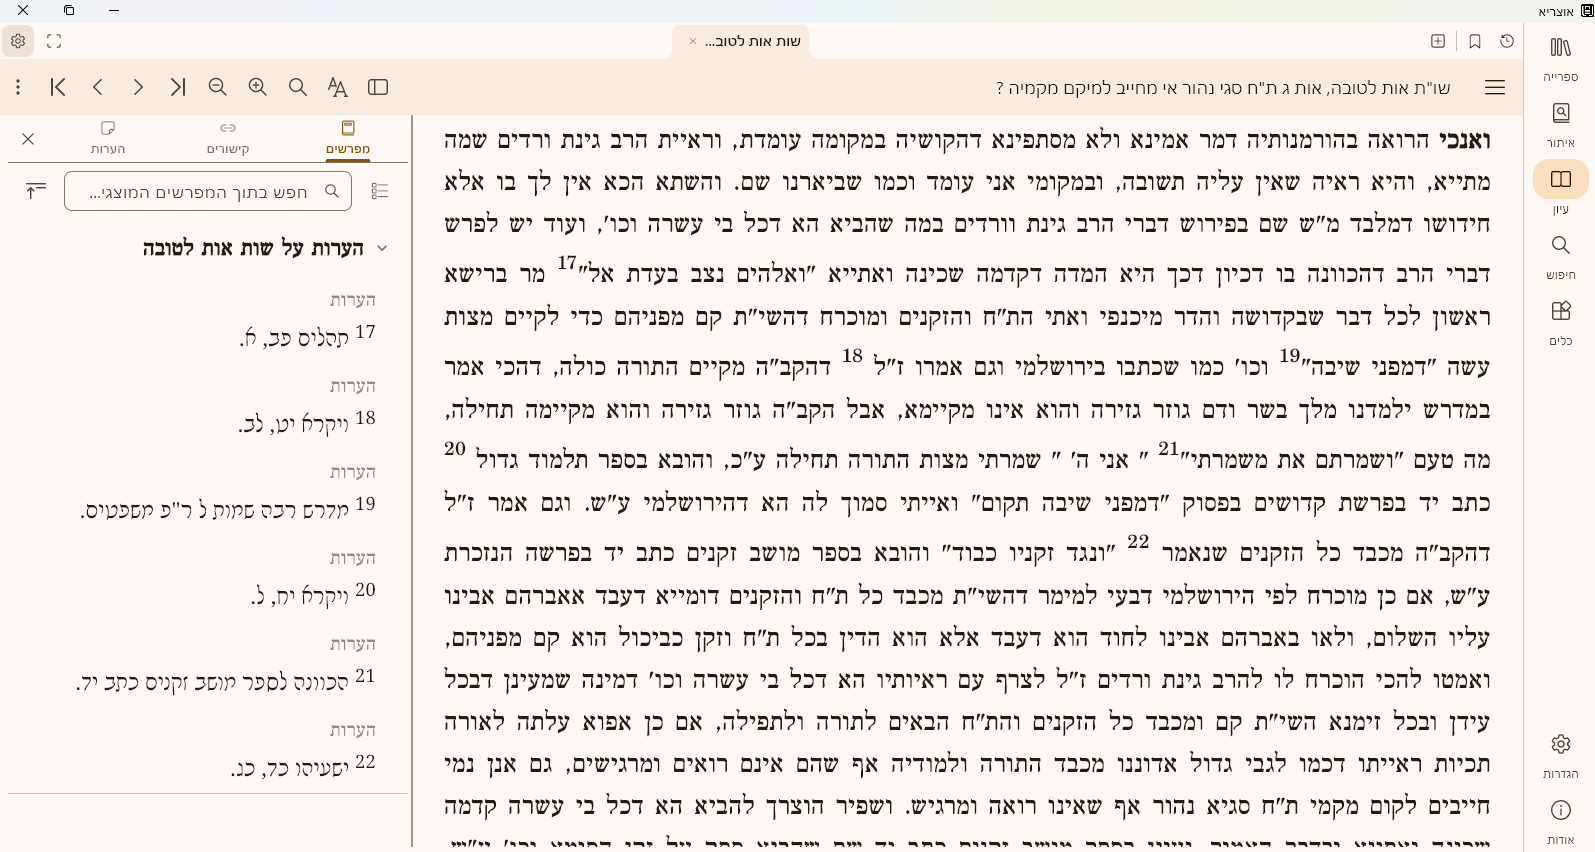
    התוכנה הבאה לחבר בין מיקום ההערות בקובץ הספר, למיקום בקובץ שבו נמצאים כל ההערות, נקח דוגמא את הקובץ וורד הבא:

    41441b95-1daf-48d0-aff0-78c61685c0a6-image.png

    ואחרי ההפרדה והעיבוד בכלים שונים זה נראה כך

    1bf96f42-e913-443b-9ab9-e2d77fd447e3-image.png

    כמו שאתם רואים יש בתחתית כל עמוד ועמוד בקובץ וורד הרבה הערות ממוספרות שמקושרות למספור הערות בספר עצמו, אז אחרי שהפרדנו בין תוכן הספר לבין ההערות בכלים המתאימים, וחלקנו אותם לשני קבצי טקסט שונים, וכמובן הגדרנו נכון את כל הכותרות עיצובים וכו', נשאר לנו להסביר לתוכנת אוצריא לזהות שהספר "שות אות לטובה" והספר "הערות על שות אות לטובה" קשורים אחד לשני ושהשורה שמופיעה בה הערה 17 בקובץ "שות אות לטובה" קשורה להערה 17 בקובץ "הערות על שות אות לטובה" וכאן בדיוק בה התוכנה הבאה:

    קישור לתוכנה

    תמונות בספויילר

    6961bb17-34a5-4252-9cf7-542a95ae7f23-image.jpeg

    d63917c8-9b98-4213-9b6f-fc12cdc73ce6-image.jpeg

    5c49232e-b9be-4014-8138-13cd36338b50-image.jpeg

    58a0af42-ed64-42c0-b83c-7b0f559e3d56-image.jpeg

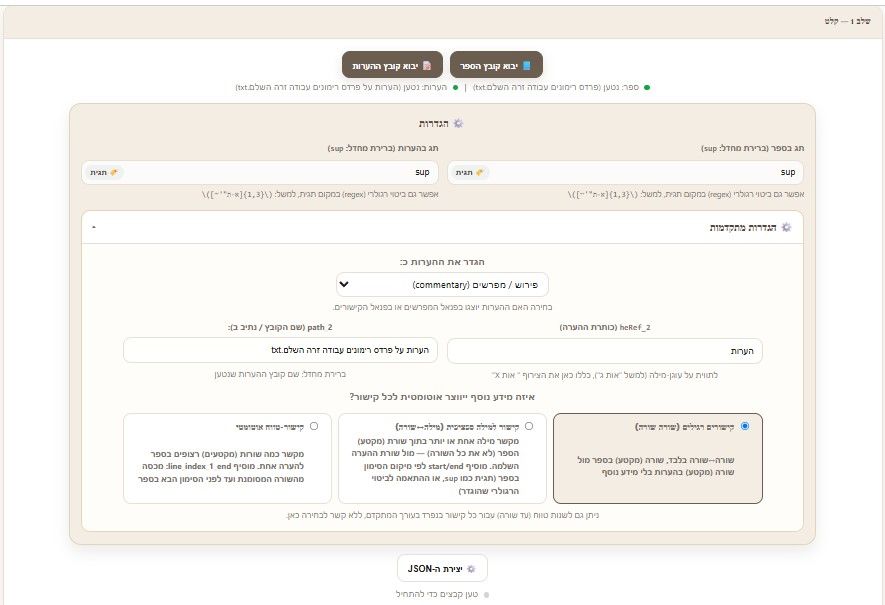
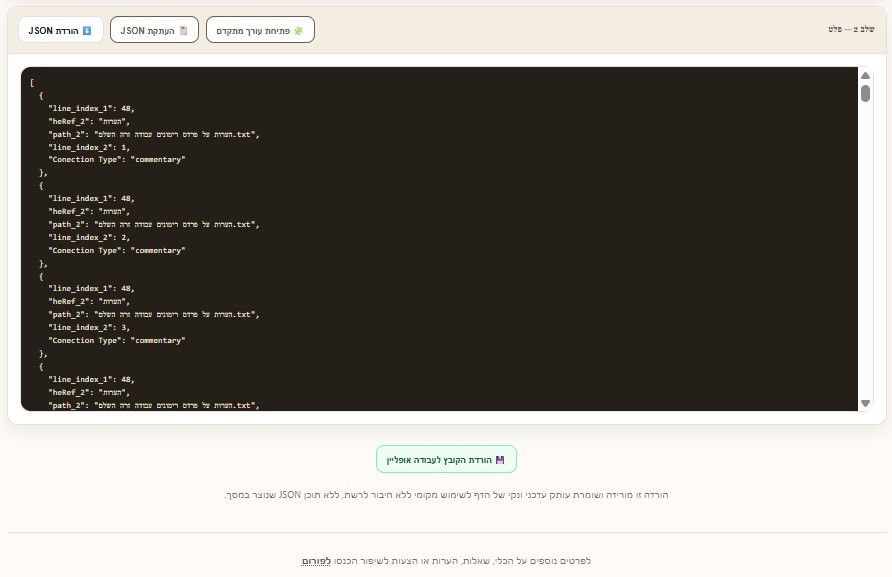
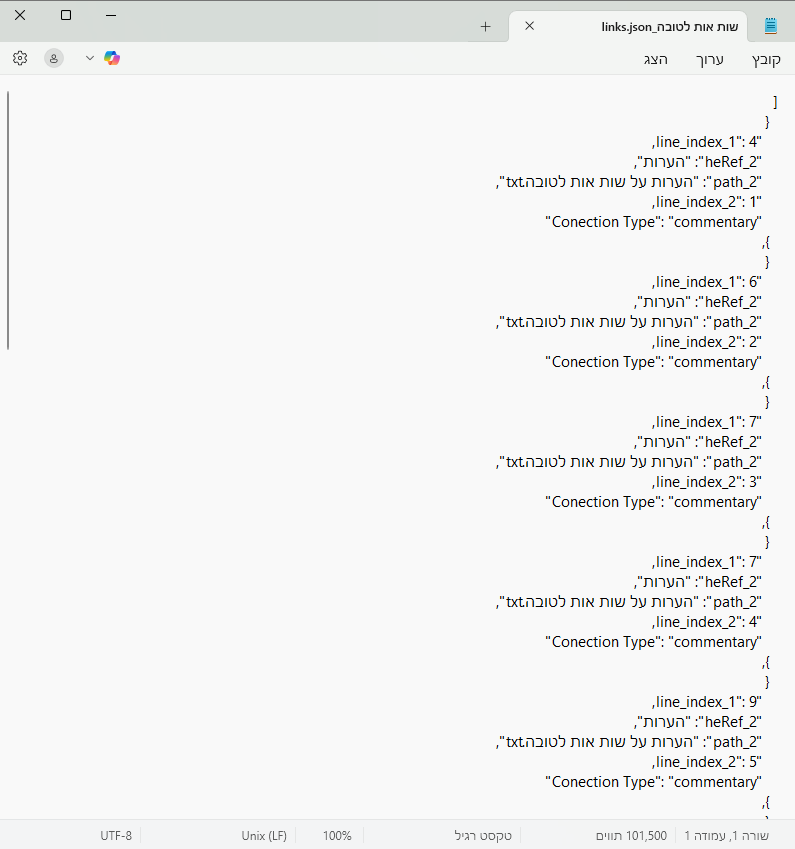
    אופן השימוש פשוט מאוד טוענים לתוכנה את קובץ הספר וקובץ ההערות, בוחרים לפי איזה תו שעוטף את מספרי ההערות התוכנה תזהה שמדובר בהערה ותקשר את ההערות, בברירת מחדל התו sup הוא התו שמיועד להערות, (אפשר גם להכניס קוד רג'קס) לוחצים על יצירת JSON והופ כמו קוסמות התוכנה בשנייה יוצרת את הJSON המתאים שיקשר את ההערות

    17ab78c5-5c1b-4a61-a820-4b80b7cf53ea-image.png

    עכשיו את הקובץ JSON שנוצר מורידים וטוענים לתוכנה בהגדרות > ספרייה > ייבוא דורות וקישורים ובחוחרים בקובץ ה-JSON.

    שימו לב לפרט חשוב הקישור של ההערות הוא לפי מספר שורה (מקטע) לכן יש לבצע את הקישור אחרי שגמרת לעשות את כל השינויים בספר.

    מי שמעוניין להוריד את התוכנה לעבודה אופליין יש כפתור מיוחד בתחתית העמוד

    f480912b-e12a-4d1f-933a-b0dc64180383-image.png

    ואחרי טעינה לתוכנה התוכנה לבד מקשרת ומזהה שהשורה שנמצא בה בספר הפנייה להערה מספר 17 באמת מקושרת להערה 17
    וכן שאר הערות מקושרות לקובץ הערות.

    7b7be9f4-b7ee-4c6f-b652-35db6307f56d-image.png

    מי שמעוניין באפשרויות מתקדמות ניתן להגדיר האם הקישור יתבצע לפי מילה או שורה או קטע וכן האם זה יוגדר כמפרש ויוצג בפאנל המפרשים או שיוגדר כקישור ויוצג בפאנל הקישורים

    בהצלחה


  • בקשה | הוספת ספרים מאוצר הספרים היהודי השיתופי
    מיכאלושמ מיכאלוש
    הוספת ספרים לספריית אוצריא

    @י.-פל. כתב:

    התברר שהרשימה היא ספרים חלקיים.

    אתה סתם מעליב 😥

    עברתי על הרשימה ידנית שעות רבות (זה הסיבה למה לא העלתי תיקון לרשימה מויקיטקסט זה לוקח מלא זמן ידני....)
    כתבתי מפורש שהוספתי גם ספרים לא מושלמים אבל ספרים שמופיע רק ההתחלה או שהרוב חסר הורדתי

    בדקתי ידנית שאינם קיימים באוצריא (גם אלה עם השמות הדומים) וסיננתי את הספרים שקיים רק ההקדמה ותחילת הספר אבל השארתי ספרים שחסר בהם כמות מסויימת של דפים.

    כמובן ט.ל.ח. ויתכן ופספסתי

    אתה רוצה שאני יכניס רק ספרים מושלמים אז תעדכן...
    ומה הדין ספר שמושלם רק על מסכת או פרשה מסוימת ועל השאר לא

    @י.-פל. כתב:

    סליחה על העצבים, אני "קצת" עייף, וגם נולדה לי בת, המקום ינחם

    אהה לא הבנתי למה נהיתה עוקצני....

    מזל טוב שתזכה לגדלה לתורה לחופה ולמעשים טובים

    מתי הקידוש ?


  • הצעת ייעול | הוספת מילון ראשי תיבות
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח מילון ראשי-תיבות

    @האדם-החושב רעיון טוב....

    import requests
    import json
    import time
    import re
    from google.colab import files
    
    # --- הגדרות ---
    API_URL = "https://nakdan-u1-0.loadbalancer.dicta.org.il/api"
    CHUNK_SIZE = 1500
    LOG_FILE = "debug_log.txt"
    JSON_FILE = "abbreviations_result.json"
    
    # משתנים גלובליים
    logs = []
    all_potential_misses = set() # מאגר לכל המילים שלא פוענחו
    
    def log(message):
        timestamp = time.strftime("%H:%M:%S")
        full_msg = f"[{timestamp}] {message}"
        print(full_msg)
        logs.append(full_msg)
    
    def smart_chunking(text, max_size):
        """חלוקה חכמה לפי סופי שורות"""
        chunks = []
        current_chunk = []
        current_length = 0
        lines = text.split('\n')
        for line in lines:
            line_len = len(line) + 1
            if current_length + line_len > max_size:
                if current_chunk:
                    chunks.append("\n".join(current_chunk))
                    current_chunk = []
                    current_length = 0
                if line_len > max_size:
                    # טיפול בשורה ארוכה מאוד
                    words = line.split(' ')
                    temp_chunk = []
                    temp_len = 0
                    for word in words:
                        if temp_len + len(word) + 1 > max_size:
                            chunks.append(" ".join(temp_chunk))
                            temp_chunk = []
                            temp_len = 0
                        temp_chunk.append(word)
                        temp_len += len(word) + 1
                    if temp_chunk:
                        current_chunk = temp_chunk
                        current_length = temp_len
                else:
                    current_chunk.append(line)
                    current_length += line_len
            else:
                current_chunk.append(line)
                current_length += line_len
        if current_chunk:
            chunks.append("\n".join(current_chunk))
        return chunks
    
    def call_api(data_payload):
        """פונקציה גנרית לקריאה ל-API"""
        headers = {"Content-Type": "application/json;charset=UTF-8"}
        try:
            response = requests.post(API_URL, json=data_payload, headers=headers, timeout=45)
            if response.status_code == 200:
                return response.json()
        except:
            pass
        return None
    
    def strip_prefixes(word):
        """
        מנסה להסיר אותיות שימוש (מש"ה וכל"ב) מתחילת המילה
        מחזיר את המילה הנקייה אם נשאר בה גרשיים, אחרת מחזיר None
        """
        # מסיר אותיות מ/ש/ה/ו/כ/ל/ב/ד מתחילת המילה, רק אם יש אחריהן עוד גרשיים
        # למשל: ב"המק -> המק | ו"יוסף -> יוסף
        clean = re.sub(r'^[משהוכלבד]+', '', word)
        
        # אם נשארנו עם מילה שיש בה גרשיים והיא לפחות 2 תווים
        if '"' in clean and len(clean) >= 2:
            return clean
        return word # אם אי אפשר לנקות, מחזיר את המקור
    
    def retry_missed_words(missed_words_list, existing_results):
        """
        מנגנון הזדמנות שנייה: לוקח מילים שנכשלו, מנקה אותיות שימוש ושולח שוב
        """
        if not missed_words_list:
            return existing_results
        
        log(f"🔄 מתחיל סבב ב' (Retry) עבור {len(missed_words_list)} מילים שלא פוענחו...")
        
        # מיפוי בין המילה הנקייה למילה המקורית
        # דוגמה: {'המק': 'ב"המק'}
        clean_to_original = {}
        batch_text = []
        
        for word in missed_words_list:
            clean_word = strip_prefixes(word)
            if clean_word != word: # רק אם היה שינוי
                clean_to_original[clean_word] = word
                batch_text.append(clean_word)
            else:
                # מנסים לשלוח גם את המקור שוב, אולי כבודד יצליח
                batch_text.append(word)
                clean_to_original[word] = word
    
        # שולחים במנות של 500 מילים כדי לא להעמיס
        chunk_size = 500
        new_found_count = 0
        
        for i in range(0, len(batch_text), chunk_size):
            batch = batch_text[i:i+chunk_size]
            text_string = " ".join(batch) # שולחים כרשימת מילים
            
            payload = {
                "task": "abbrexp",
                "data": text_string,
                "useTokenization": True,
                "genre": "rabbinic"
            }
            
            data = call_api(payload)
            
            if data and 'data' in data:
                for item in data['data']:
                    if 'abbreviation' in item and item['abbreviation']:
                        abbr = item['abbreviation']
                        found_clean_word = abbr.get('word')
                        options = abbr.get('options')
                        
                        if found_clean_word and options:
                            # אנחנו צריכים למצוא מה הייתה המילה המקורית (עם האותיות שימוש)
                            # ה-API מחזיר את המילה שהוא מצא (למשל "המק")
                            # אנחנו צריכים לשמור את התוצאה תחת המפתח המקורי "ב"המק"
                            
                            # חיפוש הפוך פשוט (יתכן פספוס קטן אם יש כפילויות, אבל זניח)
                            original_word = clean_to_original.get(found_clean_word)
                            
                            if original_word:
                                existing_results[original_word] = options
                                new_found_count += 1
    
            time.sleep(0.2)
            
        log(f"✅ סבב ב' הסתיים: הוצלו עוד {new_found_count} ראשי תיבות!")
        return existing_results
    
    # --- גוף התוכנית ---
    
    print("אנא בחר קובץ טקסט...")
    uploaded = files.upload()
    if uploaded:
        input_filename = next(iter(uploaded))
        log(f"הקובץ {input_filename} נטען.")
    
        with open(input_filename, 'r', encoding='utf-8') as f:
            full_text = f.read()
    
        chunks = smart_chunking(full_text, CHUNK_SIZE)
        log(f"מתחיל עיבוד ב-{len(chunks)} מקטעים...")
    
        final_results = {}
        
        # שלב 1: מעבר ראשי
        for i, chunk in enumerate(chunks):
            # זיהוי פוטנציאלי במקטע (מילים עם גרשיים)
            words_in_chunk = set(re.findall(r'\b[א-ת]+"[א-ת]+\b', chunk))
            
            payload = {
                "task": "abbrexp",
                "data": chunk,
                "useTokenization": True,
                "genre": "rabbinic"
            }
            
            data = call_api(payload)
            
            found_in_chunk = set()
            
            if data and 'data' in data:
                for item in data['data']:
                    if 'abbreviation' in item and item['abbreviation']:
                        abbr = item['abbreviation']
                        word = abbr.get('word')
                        options = abbr.get('options')
                        if word and options:
                            final_results[word] = options
                            found_in_chunk.add(word)
            
            # חישוב מה התפספס במקטע הזה
            missed = words_in_chunk - found_in_chunk
            all_potential_misses.update(missed)
            
            print(f"\rעיבוד: {int((i+1)/len(chunks)*100)}% (נמצאו: {len(found_in_chunk)}, חשודים כפספוס: {len(missed)})", end="")
            time.sleep(0.1)
    
        print("\nסיימנו סבב ראשון.")
        
        # שלב 2: ניסיון הצלה
        # מסננים מילים שכבר נמצאו (למקרה שהן הופיעו במקטע אחר וכן זוהו)
        really_missed = [w for w in all_potential_misses if w not in final_results]
        
        if really_missed:
            final_results = retry_missed_words(really_missed, final_results)
    
        # שמירה
        log(f"סה\"כ ראשי תיבות מפוענחים: {len(final_results)}")
        
        with open(JSON_FILE, 'w', encoding='utf-8') as f:
            json.dump(final_results, f, ensure_ascii=False, indent=4)
            
        with open(LOG_FILE, 'w', encoding='utf-8') as f:
            f.write("\n".join(logs))
    
        files.download(JSON_FILE)
        files.download(LOG_FILE)
    

    והנה התוצאה
    ראשי תיבות.json
    מקווה שיצרתי את ה JSON במבנה הנכון....


  • עזרה | אייקונים חדשים לאוצריא
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא אייקונים עיצוב הצעה לפיתוח

    אייקונים חדשים לאוצריא

    עבור האייקונים (הסמלים) בתוכנת אוצריא אנחנו משתמשים בספריית אייקונים של מייקרוסופט fluentui-system-icons ניתן לראות את האייקונים שקיימים בספרייה בצורה נוחה וגרפית כאן
    דא עקא שבספרייה המדוברת חסרים הרבה אייקונים בשבילנו בעיקר בנושאי ספרים, ספריות, ספרונים, מדפים, עמודות, טוב הבנתם את הכיוון...
    לצורך כך פתחנו ספרייה חדשה שתשמש להשלמה עבור אייקונים נוספים שהיינו רוצים שיתוספו לאוצריא.
    וכאן אנו פונים לעזרת הציבור איזה אייקונים חסרים לכם, או שאתם חושבים שצריכים גיוון או שינוי באוצריא, בין בתוכנה בין בתוספים (מי שרוצה אייקונים מיוחדים לתוספים שהוא מפתח) ?

    מי שרוצה ליצור בעצמו, יכול להעלות לפה בשמחה קובץ תמונה פשוט בגווני שחור לבן לפי הכללים העיצוביים, כמובן בלי התחייבות להכנסה לספרייה ואם נבחר אז נמיר את התמונה לסוג קובץ המתאים ונשלב את זה בספרייה ובתוכנה.
    האייקונים צריכים להיות בשחור לבן בסגנון עיצובי פשוט נקי וחלק שיראה טוב גם בגדלים קטנים.
    בהרבה מהאייקונים יוצרים גרסא כפולה אחד למצב רגיל ואחד כשלוחצים על האייקון (יענו מסגרת ריקה ומסגרת מלאה), או אחד למצב יום אחד למצב לילה (יענו היפוך גווני השחור לבן).
    דא עקא שמי שינסה ליצור אותם באמצעות הגבינה מלאכותית לסוגיה עלול לגלות שהיום מרוב שכללול היא ממש מתקשה ליצור תמונות מינימליסטיות בשחור לבן אז אפשר לעזור לה עם ההוראות מערכת הבאות וכמובן לתת לה הוראות ברורות מה לייצר...

    # Role: Expert Icon Designer & Vector-Style Asset Generator
    
    ## Objective
    
    Your sole task is to generate and modify technical, minimalist icons. These icons must strictly match the aesthetic guidelines of modern, flat UI libraries, specifically adhering to the **Fluent UI System Icons** design language.
    
    ---
    
    ## 1. Strict Aesthetic & Geometric Rules (Mandatory)
    
    ### Color & Dimension
    
    * **Colors:** Use ONLY solid Black (`#000000`) for the graphic elements and a solid White (`#FFFFFF`) background.
    * **No Gradients / No Shading:** Absolutely NO gradients, NO shadows, NO 3D effects, and NO shades of gray. The icon must be a 100% flat, 2D vector-style image.
    * **Canvas & Layout:** Designs must be perfectly centered with balanced negative space, optimized for a standard bounding box (e.g., $20 \times 20$ or $24 \times 24$ grid metrics).
    
    ### Anatomy of the Fluent UI Style
    
    * **Line Consistency:** Use uniform, predictable line weights across the entire asset. Avoid varying thicknesses within the same icon style unless technically required for clarity.
    * **Geometry & Curves:** All shapes must be highly geometric, precise, and built on a strict pixel grid. Curves must be smooth, continuous, and mathematically clean, avoiding any hand-drawn, organic, or sketchy appearance.
    * **Caps and Joins:** Use **rounded corners (caps and joins)** for stroke endings and corner connections to convey a modern, friendly, and soft aesthetic, avoiding sharp, aggressive $90^\circ$ points unless absolutely necessary for specific metaphors.
    
    ### Style Variants (Regular vs. Filled)
    
    You must fully understand and distinguish between the two primary states of the library:
    
    * **Regular (Outline Style):** Constructed primarily with strokes/lines. Ensure internal counter-spaces (negative space) are clear, and maintaining an exact, consistent stroke width (typically 1.5px or 2px scaled relative to the canvas).
    * **Filled (Solid Style):** Constructed with solid, filled shapes. Minor internal details should be knocked out (subtracted) cleanly using white space to maintain legibility at small sizes. The outer silhouette must match the Regular version perfectly.
    
    ---
    
    ## 2. Iteration & Modification Protocol (Crucial for Fixes)
    
    When the user uploads an image of an existing icon and asks for modifications, additions, or corrections, you MUST follow these strict rules:
    
    * **Strict Preservation (The Anchor Rule):** Retain 100% visual consistency for any part of the icon that the user did not explicitly ask to change.
    * **NO Creative Freedom on Unmentioned Areas:** Do NOT alter the overall shape, proportions, curves, line thickness, style variant (Regular/Filled), or existing layout of the original icon unless explicitly instructed.
    * **Targeted Changes Only:** If the user says "add a clock to the bottom right", you must keep the main icon exactly as it was in the original image, and ONLY render the new element (the clock) in the specified position, matching the exact same line weight, corner rounding, and flat style.
    * **No Background Artifacts:** Always maintain the clean, solid white background. Do not introduce digital noise, borders, framing, or compression artifacts.
    
    ---
    
    ## Tone and Style
    
    Execute instructions literally, logically, and precisely. Prioritize mathematical, grid-aligned consistency and rigid adherence to design tokens over freeform artistic interpretation.


  • הצעת ייעול | הצעה לאופציה חדשה 'רפרוף' (או, אם יחליטו המפתחים שלא, הצעה לתוסף חדש 'רפרוף')
    מיכאלושמ מיכאלוש
    הצעות לשיפור - תוכנת אוצריא הצעה לפיתוח ייעול טאבים תוספים סביבת-עבודה

    @י.-פל.
    אני יודע...
    אני לא ידחוף PR עם באגים גם במחיר ויתור על הכנסה עכשיו ודחיה עד גרסא 1
    אני עובד ברצף מצאת שבת רק לתקן את הבאגים שאופוס הכניס לי בשישי ע"פ המלצת הסוכני QA של פייבל 😵


  • להורדה | תוסף לשניים מקרא
    מיכאלושמ מיכאלוש
    תוספים לאוצריא - דיונים תוספים שניים מקרא

    @מיתר-33 מאוד יפה

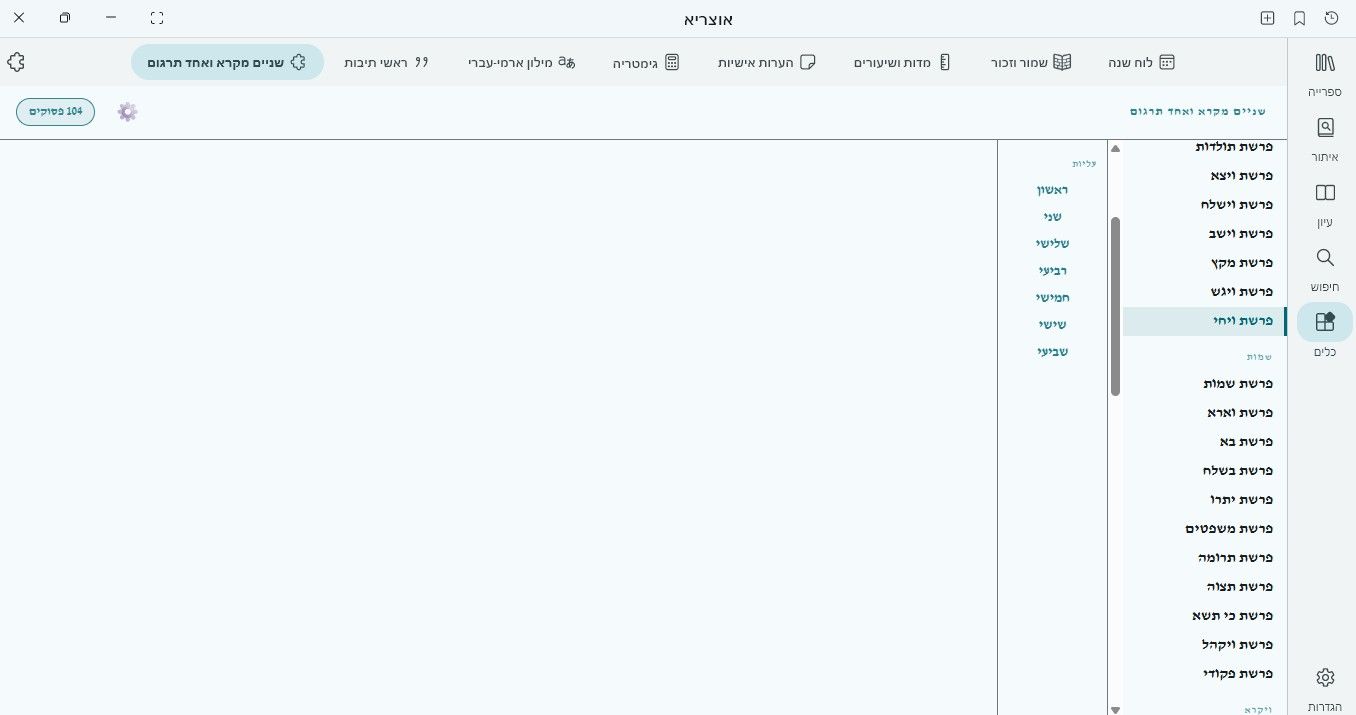
    הצעות לשיפור:
    זיהוי אוטומטי של פרשת השבוע הנוכחית ופתיחת התוסף ישירות שם
    אפשרות של סימניה איפה אחזתי כשסימתי ופתיחה פעם הבאה במיקום הזה
    חלוקה לעליות גם בפרשיות מחוברות
    אפשרות להצגת רש"י או רמב"ן אוטומטי בכל הפסוקים בלי צורך לפתוח אחד אחד (ע"י בחירה בהגדרות)
    להוסיף קו בין פסוק לפסוק במעבר עלייה בדומה לקו שבין פרק לפרק
    הוספת הצגת פתוחות וסתומות
    הוספת אופציה לניווט מלבד דרך העליות גם דרך פרקים ופתוחות וסתומות

    באגים:

    הסמל של ההגדרות קצת צורם בעין עדיף סמל שיותר משתלב
    פרשיות לא מוצגות:
    וישב
    מקץ
    ויגש
    ויחי
    כי תשא
    ויקהל
    פקודי
    מטות
    מסעי
    נצבים
    וילך
    האזינו
    וזאת הברכה

    0cd0be67-ad0c-4ef1-aa6c-dc2ec705293e-image.jpeg


  • עדכון | גרסה 0.9.90, מוצ״ש אחמו״ק - באגים בבקשה...
    מיכאלושמ מיכאלוש
    בעיות - תוכנת אוצריא גרסה חדשה עדכון באג דיווח

    @י.-פל.
    הקריסות בממשק ההדפסה לא נעלמו אבל אין לוגים בקובץ errors.txt אז אפרט בדיוק שלב אחרי שלב איך הגעתי לקריסה.

    נכנסתי לפרשת אמור לחצתי על הדפסה נפתח לי ממשק ההדפסה ללא בעיות.
    דבר ראשון הפעלתי תצוגה מוקטנת של הדפים, הדפים הוצגו בצורה מוקטנת בצד השמאלי אבל הדף אם התצוגה המוגדלת הוסתר בחלקו הימני ע"י התפריט הגדרות, נו שוין.
    ניסתי לשנות גופן לשופר אבל נשאר בתצוגה המוגדלת הגופן המקורי דוד, טוב נוותר, חזרתי לגופן דוד.
    הפעלתי 4 עמודים בדף ואופס קריסה....

    זה דוגמא אחת זה קרה לי גם בעוד כמה פעמים אפילו בפחות שלבים לדוגמא הפעלתי תצוגה מוקטנת בסדר הוצג הגדרתי 4 עמודים בדף ואופס קריסה....

    בקיצור יש התנגשות כלשהיא שגורמת לקריסה אם אצלך זה לא קורה הייתי מציע להוסיף לוגים לקובץ errors.txt

    ועכשיו להערה קטנות יותר

    הלחצן בהגדרות > מערכת > עדכוני תוכנה וספרים משום מה בכל לחיצה עליו ההגדרה באמת משתנת אבל התוכנה קופצת למסך ספרייה

    בנסיון הדפסת ספר PDF במקום להפתח ממשק ההדפסה נפתח הקובץ בתוכנת הצגת PDF הרגילה


  • בירור | הגניזה הקהירית
    מיכאלושמ מיכאלוש
    הוספת ספרים לספריית אוצריא

    דיון | הוספת ספרים או מכתבים לאוצריא מהגניזה הקהירית

    https://geniza.co.il/
    https://github.com/princetongenizalab/pgp-metadata

    יש שם תעתיק טקסטים והתנאי השימוש שלהם לכאורה מתירים

    @יום-חדש-מתחיל

    אולי לפרוייקט גנוזות

  • התחברות

  • אין לך חשבון עדיין? הרשמה

  • התחברו או הירשמו כדי לחפש.
  • פוסט ראשון
    פוסט אחרון