עדכון | ימים חדשים לפנינו: הOCR לספרים חוזר, ובענק!
-
@חנניה
 לא הבנתי קודם כוונתך.
עוד בקשה - ברשימת מילים חשודות, כאשר בוחרים מילה חילופית בבקשה לעשות שיקפוץ אוטומטי למילה הבאה (כמו שקורה כאשר מאשרים שהמילה תקינה).
תודה רבה -
-
-
האם מותר לשאול
האם מישהו מנסה להוסיף איזה בינה לזה, תראה המצורף בדף שהעליתי לבינה בלי העלאת דף המקורבעיון בקטע מצאתי לפחות 8 שיבושי OCR ברורים, ועוד כמה מקומות חשודים, ובכללם חילופי אותיות מהסוג שציינת. יש גם טעות בהפניה לפרק בתהלים, והערת שוליים שנכנסה בטעות לתוך גוף הפירוש.
זיהיתי שהקטע הוא ככל הנראה מתוך פירוש החסיד רבי יוסף יעב״ץ לתהלים, על מזמור ל׳, פסוקים ה׳–ו׳. איתרתי את הספר בקטלוג הספרייה הלאומית, אך עדיין לא השוויתי את הקטע לתצלום הדפוס עצמו.
הספרייה הלאומית+1א. שיבושים ברורים
נוסח ה־OCR הנוסח הנכון הערה
פן אכלך כר׳ פן אכלך כו׳ ר במקום ו
כי או היה במשמע כי אז היה במשמע תיקון כמעט ודאי לפי הענין
ולבקר ירמחז ולבקר ירמוז ח במקום ו
מן הסכלות גר מן הסכלות וגו׳ שיבוש בקיצור
צורך לחבמה צורך לחכמה ב במקום כ
זמרו על כבה חסידיו זמרו על ככה חסידיו ב במקום כ
כמאמר המשודר כמאמר המשורר ד במקום ר
על תסתר מניך אל תסתר פניך שתי טעויות בציטוט הפסוקהביטוי ״ברחקי ממך מותי בחיי, ואם אדבק בך חיי במותי״ הוא משירו של רבי יהודה הלוי, אדני נגדך כל תאותי, ולכן ברור שצריך להיות המשורר.
kotar.cet.ac.il+1ב. מקומות חשודים שצריך לבדוק בדפוס
הנוסח שלפנינו תיקון אפשרי מידת הביטחון
להיותנו דבקים בו להיותכם דבקים בו בינונית. לפני כן כתב ״סבלתם״, ואחר כך ״לכם״
ר״ל ראיתי בחכמתו ראיתי בחכמתי בינונית. אם הדברים נאמרים בלשון שלמה עצמו, מסתבר ״בחכמתי״
כי הסכלות והוא הפך החכמה כי הסכלות שהוא הפך החכמה אפשרי, אבל ״והוא״ יכול להיות מאמר מוסגר
כמו שמתיקות האור לא יוכר לא תוכר תיקון דקדוקי מסתבר, אך ייתכן שכך לשון המחברבפרט, ״ראיתי בחכמתו״ טעון בדיקה. ייתכן שהמחבר עבר לדבר על שלמה בגוף שלישי, ולכן אין להחליפו אוטומטית.
גם הביטוי ״מתיקות האור״ אינו רגיל, אך אין סיבה מספקת לשנותו בלי לראות את המקור.
ג. טעות בהפניה והערת שוליים
בסוף הקטע נכתב:
עיין במזמור כ״ו בפסוק על תסתר מניךצריך להיות:
עיין במזמור כ״ז בפסוק אל תסתר פניך.
הפסוק הוא בתהלים כ״ז, ט׳, ולא בפרק כ״ו.
ויקיטקסט+1נוסף על כך, האות א) שאחרי ״ושפתי צדיק ידעון רצון (משלי י׳)״ היא סימן להערת שוליים. בהמשך נכתב ״א) ושפתי צדיק כו׳״, שהוא תחילתה של אותה הערה. יש להפריד אותה מגוף הפירוש, ולא להשאירה ברצף.
ד. דברים שבדקתי ונמצאו נכונים- ההפניה לבבא מציעא ל״ג ע״ב נכונה, וכן תוכן הדרשה על תלמידי חכמים ועמי הארץ.
בבא מציעא לג ב - לשון הפסוק בקהלת ב׳, י״ג, ״וראיתי אני שיש יתרון לחכמה מן הסכלות״, נכונה.
ויקיטקסט - ״ולבקר רנה״, בלא בי״ת נוספת, הוא אכן נוסח הפסוק בתהלים ל׳, ו׳. אין לתקנו ל״ובבקר״, שכן כל דברי המחבר בנויים על דיוק זה.
ויקיטקסט - ״לאור באור החיים״ אינו שיבוש בהכרח; זהו ביטוי מקראי (איוב ל״ג, ל׳).
מסקנה
יש כאן שיבושי OCR ממשיים, אבל רוב הקטע נראה קריא, ואין הצדקה לשנות את לשונו הרחבה על פי סברה בלבד.
אני ממליץ לתקן מיד את שמונת השיבושים הברורים, את ההפניה למזמור כ״ז ואת מיקום הערת השוליים. את ארבעת המקומות המסופקים כדאי להשאיר מסומנים לבדיקה.
מצאתי גם רישום של פירוש תהלים לרבי יוסף יעב״ץ בספרייה הלאומית. אם תעלה צילום של העמוד המקורי, אוכל להשוות אות באות ולהכריע גם במקומות המסופקים, במקום להסתמך על הסתברות לשונית בלבד.
- ההפניה לבבא מציעא ל״ג ע״ב נכונה, וכן תוכן הדרשה על תלמידי חכמים ועמי הארץ.
-
האם לא אפשר לשפר המערכת ע"י שתלמוד את צורת האותיות של הספר המסוים מתוך התיקונים שנעשו בו, ובכך לשפר בהדרגה את זיהוי האותיות בכל הספר, בשלושה שלבים:
שלב א' – לימוד מתוך דפים שכבר תוקנו
לאחר שמתקנים ידנית מספר דפים, המערכת משווה את הטקסט המתוקן לתצלומי הדפים המקוריים, ולומדת מהם את צורת האותיות המיוחדת לספר זה, ובפרט את ההבדלים בין אותיות דומות, גם בצירופים שונים ובמקומות שונים במילה.
לאחר מכן היא חוזרת על כל הספר ומתקנת את הטעויות שאפשר לזהות על סמך מה שלמדה.
שלב ב' – לימוד פעיל באמצעות שאלות ממוקדות
המערכת מחפשת בכל הספר מקומות שבהם היא מסופקת בין שתי אותיות או יותר, ומציגה למשתמש רק את המילה או האות המסופקת, בצירוף תצלום המקור והאפשרויות השונות.
המשתמש בוחר את הקריאה הנכונה, והמערכת לומדת מכך לא רק לגבי אותו מקום, אלא לגבי כל המופעים הדומים בספר.
כך, במקום לעבור ידנית על מאות עמודים, אפשר לתקן מספר מצומצם יחסית של דוגמאות שיש בהן תועלת מרבית ללימוד המערכת.
שלב ג' – לימוד עצמי מתוך מקומות ברורים
המערכת מחפשת בעצמה בכל הספר מופעים של אותיות וצירופי אותיות שניתן לזהותם בביטחון גבוה, הן לפי ההקשר הלשוני והן לפי צורת האותיות.
לאחר מכן היא משווה את צורתן למקומות המסופקים, ולומדת להבחין בין האותיות גם בלי להזדקק לתיקון ידני.
לדוגמה, אם יש מאות מקומות שבהם ברור שהאות היא ד', ומאות מקומות שבהם ברור שהיא ר', אפשר להשוות ביניהם וללמוד את ההבדלים הזעירים בין שתי האותיות בדפוס המסוים, ועל פיהם להכריע במקומות מסופקים.
כמובן, צריך להיזהר שהמערכת לא תשנה את הנוסח המקורי רק מפני שלפי ההקשר נראה לה שראוי להיות כתוב אחרת. המטרה היא ללמוד לקרוא נכון את הדפוס עצמו, ולא להגיה את לשון המחבר מסברה.
הרעיון הוא ששלושת השלבים יחזרו על עצמם: כל תיקון משפר את יכולת הזיהוי, מאפשר תיקונים נוספים, ומצמצם בהדרגה את מספר המקומות הזקוקים לבדיקה אנושית.
לכאורה היתרון הגדול הוא שאין צורך במודל OCR מושלם המתאים לכל הספרים והדפוסים, אלא אפשר ליצור לכל ספר מודל המותאם לצורת האותיות שלו, תוך שימוש בדפים שכבר תוקנו ממילא.
האם אפשר לממש זאת באמצעות מערכות קיימות כגון Kraken או eScriptorium, בתוספת פיתוח מתאים?
-
-
-
@נתנאל_26 הייתי משנה טיפ-טיפה את הניסוח, כעת הוא קצת מטעה.
או מעביר שורה אחרי המילה צילום, או מוסיף את המילה 'רק' בתחילת השורה השניה. -
@נתנאל_26 הייתי משנה טיפ-טיפה את הניסוח, כעת הוא קצת מטעה.
או מעביר שורה אחרי המילה צילום, או מוסיף את המילה 'רק' בתחילת השורה השניה.@צדיק-וטוב-לו
אשתדל לשנות בנתיים
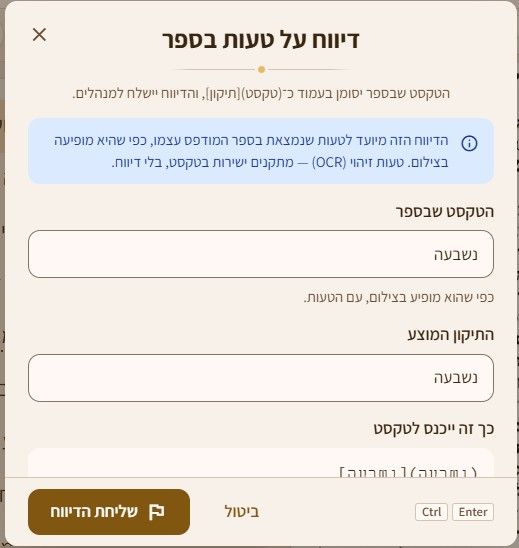
יש פרוט נרחב יותר בפאפ
-
-
-
-
-
-
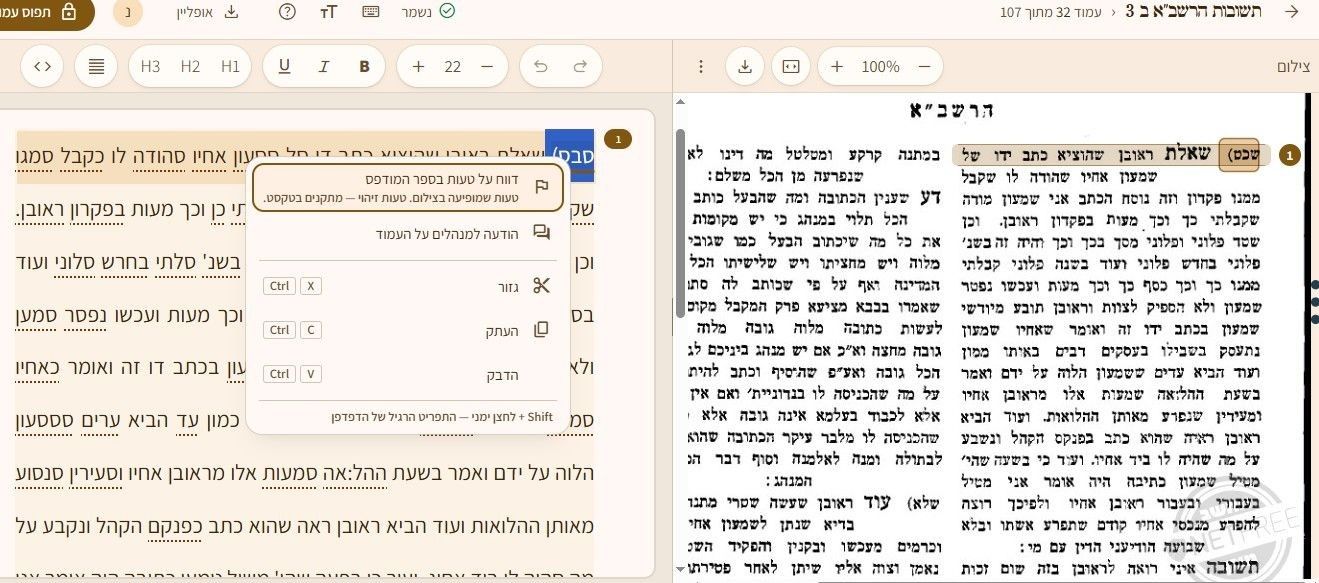
@נתנאל_26 זה לא ה OCR זה הסריקה, שהיא ברמה נמוכה יותר.
אני לא מסוגל לעבוד עם כ"כ הרבה טעויות. -
@זאב-לבן
לא חושב שזה מסביר את הרמה הנמוכה
ראיתי את המודל הזה במצבים גרועים מזה נותן זהוי הרבה יותר מדויק -
-
-
-




שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות