עדכון | עדכון: הocr החדש! צריכים את עזרתכם!
-
איך מבטלים קישורים שהתוכנת סריקה יצרה והם לא קשורים?
-
@רפאל-אא
'בקטנן'. -
-
מה זו הקטגוריה של "ממתין לזיהוי מחדש"?
אם זה גורם שיהיה צורך שהOCR יסרוק מחדש למה שזה לא יקרה מייד?
בינתיים חבל על הזמן...
יש"כ -
מה עושים כשיש סעיף ממוספר ודיבור המתחיל באותה שורה? זה לא נותן להגדיר פר מילה אלא רק פר שורה..
אשמח לפתרון
נ.ב כשחסר אות בספר המקורי, להשאיר את הטעות? -
מה זו הקטגוריה של "ממתין לזיהוי מחדש"?
אם זה גורם שיהיה צורך שהOCR יסרוק מחדש למה שזה לא יקרה מייד?
בינתיים חבל על הזמן...
יש"כבעת שינוי של מבנה השורות נדרשת זיהוי מחדש.
השרת שבו מתבצע הזיהוי לא פנוי כל הזמן לביצוע ולכן נדרשת המתנה.
-
איך להתייחס למילה בודדת ששייכת לעמוד הבא כמו הדרך בספרים הישנים שבסוף העמוד מחוץ לשורה מופיעה המילה הראשונה של העמוד הבא.
כמו כן יש לשים לב שיום שבת לא מתחשב עם 48 שעות.
אשמח לדעת האם כאשר סימנתי וי על חלק מהפסקאות זה נשמר אע"פ שעזבתי את העמוד ליותר מ - 48 שעות (עכ"פ שישמר לבא שתופס)
יישר כח, נראה ממש ברמה גבוההכמו כן יש לשים לב שיום שבת לא מתחשב עם 48 שעות.
אשמח לדעת האם כאשר סימנתי וי על חלק מהפסקאות זה נשמר אע"פ שעזבתי את העמוד ליותר מ - 48 שעות (עכ"פ שישמר לבא שתופס)למה בדיקה חוזרת מתחילה מהתחלה?
אפשר לבדוק את מה שהקודם תיקן ולבדוק שעשה נכון.
לא תמיד יש כח לבדוק את העמוד מתחילה..איך מבטלים קישורים שהתוכנת סריקה יצרה והם לא קשורים?
אלו באגים ושיפורים לאתר.
מקווה שיהיה אפשר לתקן אותם בהקדם.
-
-
-
-
באמצע הטקסט יש כותרת "חלק ה" וכאשר אני מסמן אותה בתור כותרת הוא מעביר אותה לתחילת העמוד, וכשאני מסמן הבא או 2, הוא מעביר אותה לקטע אחד אחרי.
ומשום מה בשום פנים ואופן הוא לא מוכן להשאיר אותו במקומו.באמצע הטקסט יש כותרת "חלק ה" וכאשר אני מסמן אותה בתור כותרת הוא מעביר אותה לתחילת העמוד, וכשאני מסמן הבא או 2, הוא מעביר אותה לקטע אחד אחרי.
ומשום מה בשום פנים ואופן הוא לא מוכן להשאיר אותו במקומו.אתה מנסה להגדיר אותו באמצעות מסגרת?
הוא אמור לקבל מסגרת של ראשי ובסגנונות פיסקה יש להגדיר שהוא פיסקת כותרת.
-
@פלמנמוני תכל'ס מה שנכון נכון, חוזרני בי
אם כי כמה כבר לוקח לעשות זיהוי לעמוד, אי אפשר לשחרר לכמה דקות ?@פלמנמוני תכל'ס מה שנכון נכון, חוזרני בי
אם כי כמה כבר לוקח לעשות זיהוי לעמוד, אי אפשר לשחרר לכמה דקות ?גם לא באמצע הלילה ? זה ממש הרבה זמן המתנה, למעלה מיממה
יש לזה פתרון פשוט כסף לשכור שרת אחת ותמיד זה יעזור להרבה דברים
אבל לא תמיד אנשים תורמים אפי' לדברים כאילו טוביםhttps://otzaria.org/forum/topic/2395/בקשה-קנה-לך-סנגור-ליום-הדין
-
-
-
לפני הפוסט, אני חושב שמגיע לכם הסברים על התהליך שעבר הocr, והעבודה שעשיתם.
אז ככה. @פלמנמוני התחיל ביצירת ocr מ-0. זו הייתה עבודה מפרכת, ואתם נרתמתם אליה - ושיפרתם מאוד את המודלים.
המודלים התקדמו, והגיען לאחוזי דיוק יפים (כ94%-96%).
(יש 2 מודלים: אחד לכתב רש״י ואחד לכתב מרובע).
דא עקא, ש96% זה נורא ואיום: בכל שורה יש כ13 מילים, כפול 5 תווים (כולל הרווח) - 65 תווים בעמוד, שזה אומר שגיאה כל 2 שורות...
ולכן הוחלט שפחות מ98% לא מספיק, והיעד הראשוני הוא 99-99.5%, בשאיפה להגיע ל99.8%.
פלמוני לקח חופש לקראת סוף הקיץ, לאח״מ התקדם מעט, אך הפיתוח לא המשיך משמעותית (בין השאר, כי זה זלל לנו את כל הטוקנים של כולם...)
בלי קשר בכלל, הרב @סתם-אחד החליט להכנס לעניין - מזווית שונה: לא לאמן מודל מ-0, אלא לקחת מודל קיים - ולאמן אותו על עברית.
ההבדל בין 2 הגישות הוא ענק: בעוד שאת המודל של פלמוני יכולנו לשלב בתוכנה (כל מודל שקל פחות מ10MB, רץ על הCPU), המודלים של סתם-אחד הם גדולים בהרבה, ובריצה על מחשב רגיל כל עמוד לוקח מעל ל-10 דקות, ולעת עתה הם ירוצו על המחשב-שרת שהשאיל לנו הרב @dudua99 .
אחרי שהם יהיו מוכנים - הם כמובן יוכלו לשמש לאימון זול למודל של @פלמנמוני שיתכן שיגיע עם זה לאחוזים הרצויים, אבל את זה אי אפשר לחזות מראש.
המודלים של @סתם-אחד אכן ממלאים את עבודתם נאמנה: אחוזי דיוק גבוהים מאוד בזיהוי התווים הן של כתב רש"י והן של כתב מרובע (למען הידע במודל רש"י אנו אוחזים כעת בגירסה 06).
השלב הבא בפיתוח המערכת היא יכולת זיהוי נכון של מבנה הדף ומה קיים בדף.
כלומר, האם הדף מכיל טקסט ראשי והערות, אלו שורות נכללות בטקסט הראשי ואלו בהערות, אלו שורות הן בהגדרה של ריהוט דף - כותרת רצה, כותרת מעל הערות, מספרי עמוד ועוד.
בנוסף יכולת זיהוי של אלו שורות הן כותרות ואלו הטקסט רץ.
הגירסא המופיעה כרגע באתר הינה גירסת בטא ראשונית הדורשת את האימון והשיפור של מתנדבים.
כתובת האתר: https://otzaria.org/library/page-proofכרגע עלה לאתר הספר חכמת אדם וחלק ראשון של הספר גדולי תרומה. ספרים אלו הם בתכנון להכניס אותם למאגר הספרים לאחר השלמת ההגהה.
בנוסף יעלו בעז"ה בהמשך החלקים הנוספים של הספר גדולי תרומה וחלקי ספרים נוספים אשר בתכנון להכניס אותם למאגר ומשמשים כרגע לאימון המערכת.כל הגהה ותיקון באתר משמשים לשיפורן ואימון עתידי של המערכת!
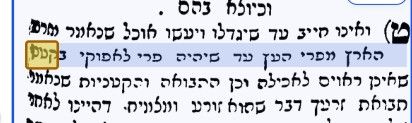
- המערכת מבוססת על זיהוי של שורות שלמות בבת אחת, ולכן היא חותכת את העמוד לשורות הנשלחות לזיהוי. בידקו האם השורות נחתכו כראוי ושום שורה לא נחתכה לשניים או שהיא זולגת לטור אחר.
- בכדי לזהות את מבנה הדף המערכת מנסה לצייר מסגרות סביב אזורי טקסט המגדירות את סוג הטקסט האם מדובר בטקסט ראשי או הערות וכן את סדר הקריאה. נדרש לתקן את המסגרות השונות על הדף בכדי לאמן את המערכת לעתיד.
- חלוקה נכונה לפסקאות. יש לעבור ולבדוק האם המערכת חילקה בצורה נכונה את הטקסט לפסקאות, ובמקרה של שיבוש לתקן.
- סגנונות פיסקה ותו, קישורים להערות. כל ספר באוצריא מקודד בצורה שהתוכנה מזהה פסקאות שונות כפסקאות כותרת והדגשות של מילים באמצע פיסקה ובנוסף כוללת דף מידע על הקישורים השונים בין הטקסט הראשי להערות. המערכת כרגע אינה מסוגלת לזהות אותם באופן אוטומטי ויש ליצור אותם ידנית.
- הגהת הטקסט. ב"ה והמערכת הגיעה לתוצאות גבוהות במיוחד בזיהוי תווים אך עדיין היא יכולה לטעות. כל הגהה של הטקסט ואישור של שורות מתוקנות משמש לאימון של מודל חדש משופר יותר.
סגנונות פיסקה ותו, קישורים להערות. כל ספר באוצריא מקודד בצורה שהתוכנה מזהה פסקאות שונות כפסקאות כותרת והדגשות של מילים באמצע פיסקה ובנוסף כוללת דף מידע על הקישורים השונים בין הטקסט הראשי להערות. המערכת כרגע אינה מסוגלת לזהות אותם באופן אוטומטי ויש ליצור אותם ידנית.
אם אני לא מכיר את כללי הקידוד הרלוונטים, יש לי במה לעזור?
-
-
סגנונות פיסקה ותו, קישורים להערות. כל ספר באוצריא מקודד בצורה שהתוכנה מזהה פסקאות שונות כפסקאות כותרת והדגשות של מילים באמצע פיסקה ובנוסף כוללת דף מידע על הקישורים השונים בין הטקסט הראשי להערות. המערכת כרגע אינה מסוגלת לזהות אותם באופן אוטומטי ויש ליצור אותם ידנית.
אם אני לא מכיר את כללי הקידוד הרלוונטים, יש לי במה לעזור?
לכאורה כן.
תיכנס ותראה. -
לי אישית אני מרגיש שעושה לי הרבה בלגן שיש כ"כ הרבה פרטים להתייחס עליהם, השאלה היא האם יש איך לתת מיקוד נפרד על כל חלק (הגהת הספר לבד, ריהוט לבד וכותרת לבד)
-
אני מתכוון שבכל דף צריך לטפל במלא דברים. א. הגהת הכתב. (ובמקרים מסוימים לציין שזה שגיאת דפוס) ב. הגדרת פסקה אחת. ג. לבדוק איזה סוג כותרת. ד. להגדיר מה שייך לריהוט הדף. ה. לבדוק את השורות שכל הפסקה מוקפת.
ההצעה שלי היא לחלק את זה או עכ"פ לתת אפשרות כזאת שקודם כל יוצגו רק הטיפול באותיות א' וב' ולאח"כ הטיפול בגוף הפסקה (כלומר בזיהוי הכותרות והמקטעים). בטיפול בגוף הפסקה אפשר לעשות שיוצג הפידיאף על מסך מלא ללא הטקסט לצידו.
כמו כן לתת אפשרות שיוצג במה טיפלתי כבר מתוך הפסקאות.
יישר כח על ההיענות והטרחה המרובה -




שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות