עדכון | עדכון: הocr החדש! צריכים את עזרתכם!
-
-
@י.-פל. המודל של כתב הרש"י מתקשה מאד בהבנת כתב מרובע...
כך שאם ישנם אותיות בטקסט מרובעות הוא לא מזהה אותם...
יהווה בעיה רצינית בהבנת דיבור המתחיל -
-
הלחצנים לביטול כן עובדים?
צודק זה בעיה בכל הקונטרול Z ובלחצן זה כן עובד (בעיה של פריסת עברית)
לגבי ביטול שורה, האם אתה נמצא בתצוגת שורות או מסגרות?
לא ביטול שורה כונתי לשורה בולטת (אם אני רוצה לאמן את המודל שזה לא בולט)
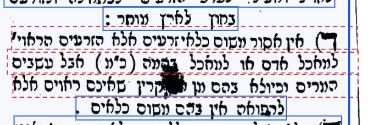
בתצוגת שורות יש לך אפשרות להקטין או להגדיל את גודל השורה.
-
-
@סתם-אחד
מה זה ממתין לזהוי מחדש איך אני מפעיל את הזזהוי כי אי אפשר לאשר דף שיש לו הרבה טעיות במסגרת כך שלעבוד על הטקסט שחלקו צריך זהוי מחדש יש ענין -
-
@סתם-אחד
מה עושים במצב כזה?
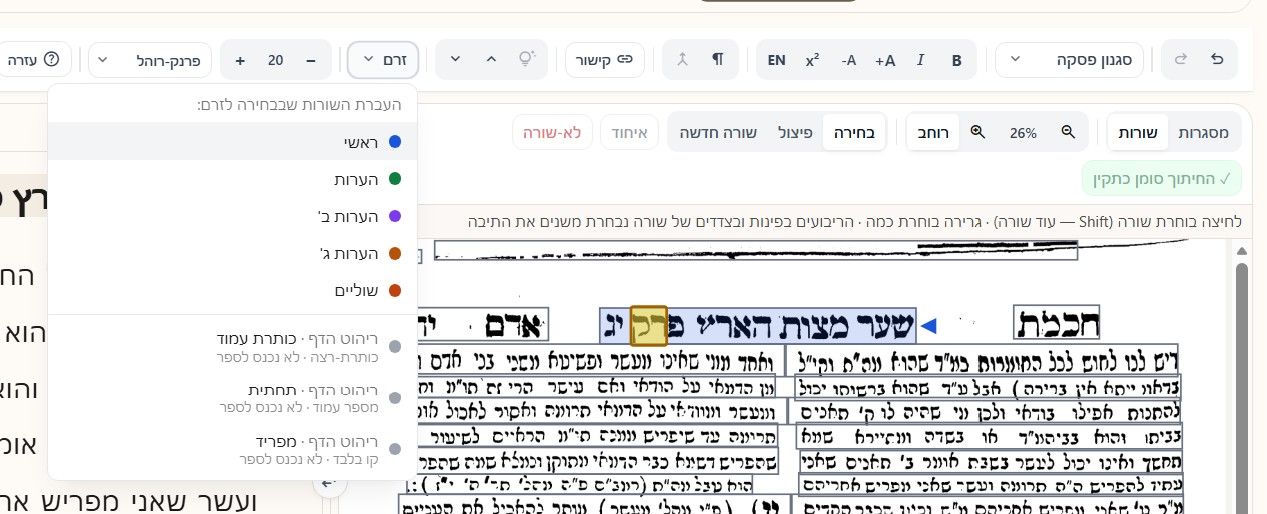
הOCR זיהה את כל השורות נכון, אבל הוא מכניס את המילה חכמת - לשורה השניה, ולא מזהה את זה ככותרת (חכמת אדם)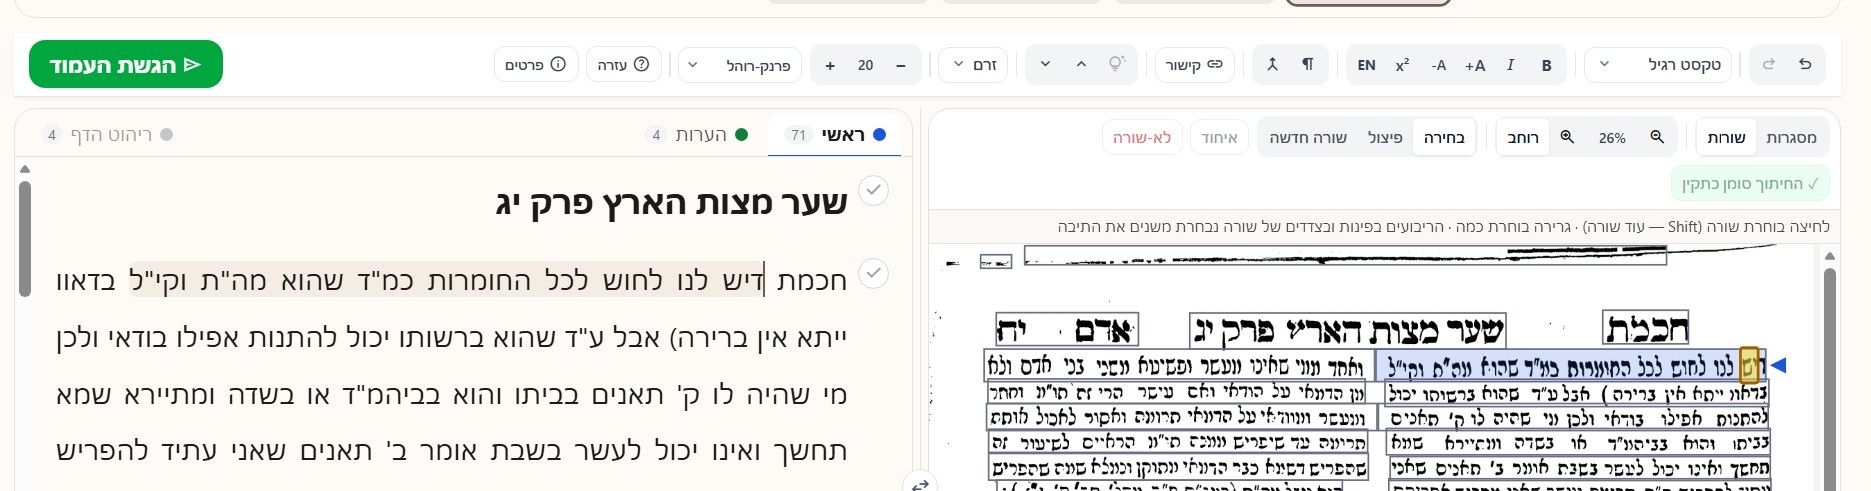
עוד שאלה - האם כותרת כזו - של הפרק, צריכה להיות מוגדרת כ"ריהוט הדף"? או שאין כותרת בגוף הטקסט על תחילת פרק יג - כך שהטקסט הזה נצרך?
עריכה:
שאפו על העיצוב והממשק והנוחות!
ממש קל לעבור על הטקטסט - עם החיצים במקלדת, מכיוון שהאתר מזהה לבד את השורה הרלוונטית ומדגיש אותה בשני החלקים - בצילום ובטקטסט המחולץ.כולם מוזמנים לנסות, זה ממש קל!
עריכה 2:
לתשומת לב המפתחים - שמתי לב שיש לו טעות קבועה (חלק מהפעמים, לא בכולם) שבה הוא מזהה את האות "מ" בכתב רש"י כ"ונ".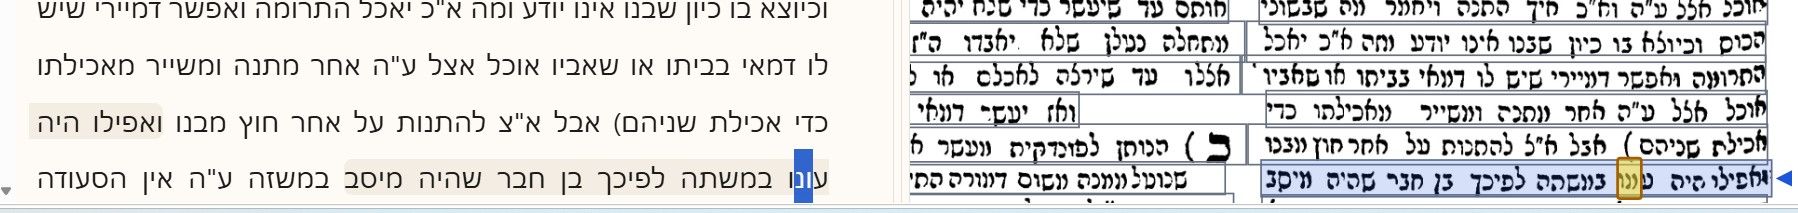
עריכה 3:
מה עושים במקרה הבא = הוא מזהה נכון, כיון שהאות |ו" שבורה, ומבחינתו זה "י" - אבל בבאמת זה "ו". להשאיר כ "י" נכון?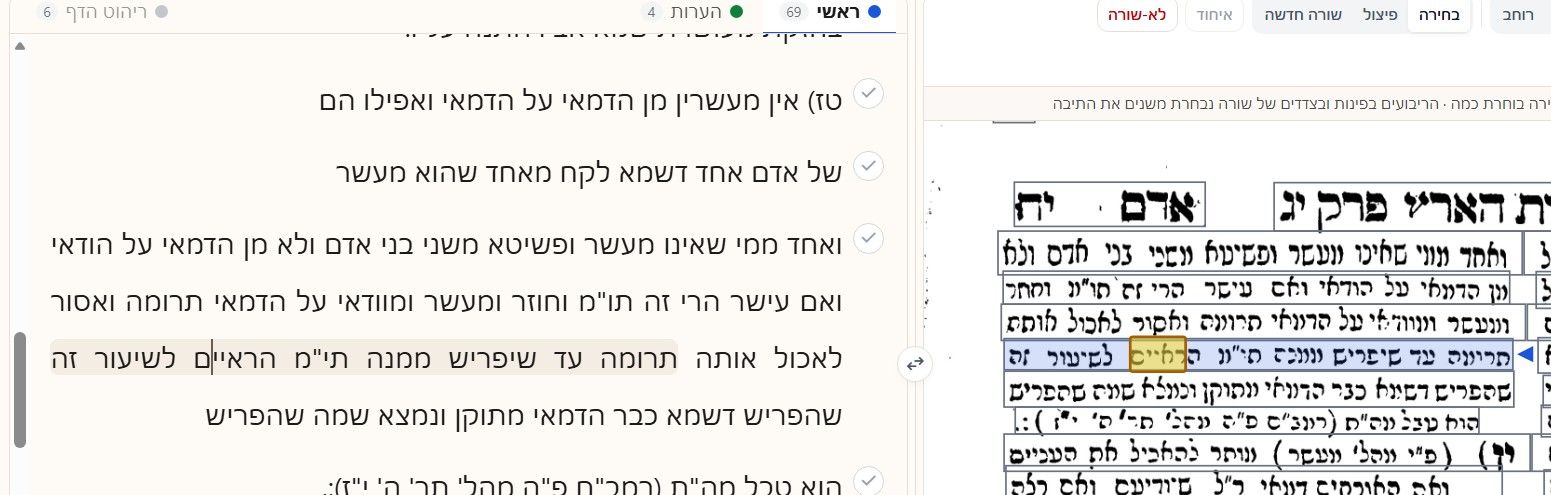
עריכה 4:
מה עושים במקרה כזה של האות "א-ל" מחובר? ללמד אותו שזה "א" ו "ל"?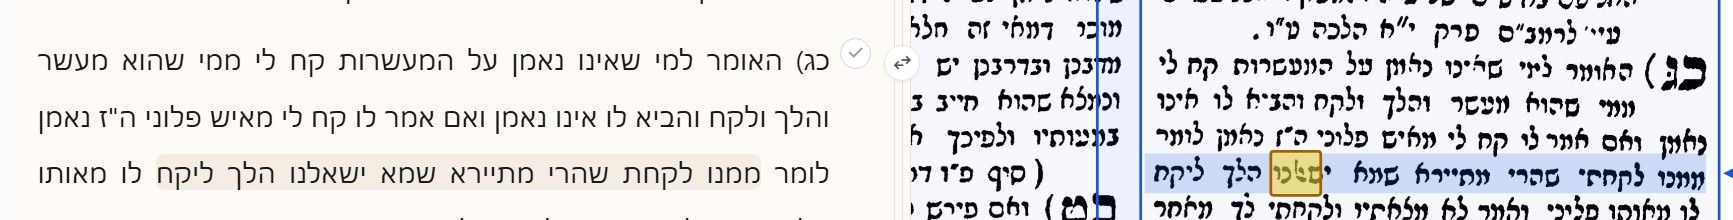
-
-
-
לפני הפוסט, אני חושב שמגיע לכם הסברים על התהליך שעבר הocr, והעבודה שעשיתם.
אז ככה. @פלמנמוני התחיל ביצירת ocr מ-0. זו הייתה עבודה מפרכת, ואתם נרתמתם אליה - ושיפרתם מאוד את המודלים.
המודלים התקדמו, והגיען לאחוזי דיוק יפים (כ94%-96%).
(יש 2 מודלים: אחד לכתב רש״י ואחד לכתב מרובע).
דא עקא, ש96% זה נורא ואיום: בכל שורה יש כ13 מילים, כפול 5 תווים (כולל הרווח) - 65 תווים בעמוד, שזה אומר שגיאה כל 2 שורות...
ולכן הוחלט שפחות מ98% לא מספיק, והיעד הראשוני הוא 99-99.5%, בשאיפה להגיע ל99.8%.
פלמוני לקח חופש לקראת סוף הקיץ, לאח״מ התקדם מעט, אך הפיתוח לא המשיך משמעותית (בין השאר, כי זה זלל לנו את כל הטוקנים של כולם...)
בלי קשר בכלל, הרב @סתם-אחד החליט להכנס לעניין - מזווית שונה: לא לאמן מודל מ-0, אלא לקחת מודל קיים - ולאמן אותו על עברית.
ההבדל בין 2 הגישות הוא ענק: בעוד שאת המודל של פלמוני יכולנו לשלב בתוכנה (כל מודל שקל פחות מ10MB, רץ על הCPU), המודלים של סתם-אחד הם גדולים בהרבה, ובריצה על מחשב רגיל כל עמוד לוקח מעל ל-10 דקות, ולעת עתה הם ירוצו על המחשב-שרת שהשאיל לנו הרב @dudua99 .
אחרי שהם יהיו מוכנים - הם כמובן יוכלו לשמש לאימון זול למודל של @פלמנמוני שיתכן שיגיע עם זה לאחוזים הרצויים, אבל את זה אי אפשר לחזות מראש.
המודלים של @סתם-אחד אכן ממלאים את עבודתם נאמנה: אחוזי דיוק גבוהים מאוד בזיהוי התווים הן של כתב רש"י והן של כתב מרובע (למען הידע במודל רש"י אנו אוחזים כעת בגירסה 06).
השלב הבא בפיתוח המערכת היא יכולת זיהוי נכון של מבנה הדף ומה קיים בדף.
כלומר, האם הדף מכיל טקסט ראשי והערות, אלו שורות נכללות בטקסט הראשי ואלו בהערות, אלו שורות הן בהגדרה של ריהוט דף - כותרת רצה, כותרת מעל הערות, מספרי עמוד ועוד.
בנוסף יכולת זיהוי של אלו שורות הן כותרות ואלו הטקסט רץ.
הגירסא המופיעה כרגע באתר הינה גירסת בטא ראשונית הדורשת את האימון והשיפור של מתנדבים.
כתובת האתר: https://otzaria.org/library/page-proofכרגע עלה לאתר הספר חכמת אדם וחלק ראשון של הספר גדולי תרומה. ספרים אלו הם בתכנון להכניס אותם למאגר הספרים לאחר השלמת ההגהה.
בנוסף יעלו בעז"ה בהמשך החלקים הנוספים של הספר גדולי תרומה וחלקי ספרים נוספים אשר בתכנון להכניס אותם למאגר ומשמשים כרגע לאימון המערכת.כל הגהה ותיקון באתר משמשים לשיפורן ואימון עתידי של המערכת!
- המערכת מבוססת על זיהוי של שורות שלמות בבת אחת, ולכן היא חותכת את העמוד לשורות הנשלחות לזיהוי. בידקו האם השורות נחתכו כראוי ושום שורה לא נחתכה לשניים או שהיא זולגת לטור אחר.
- בכדי לזהות את מבנה הדף המערכת מנסה לצייר מסגרות סביב אזורי טקסט המגדירות את סוג הטקסט האם מדובר בטקסט ראשי או הערות וכן את סדר הקריאה. נדרש לתקן את המסגרות השונות על הדף בכדי לאמן את המערכת לעתיד.
- חלוקה נכונה לפסקאות. יש לעבור ולבדוק האם המערכת חילקה בצורה נכונה את הטקסט לפסקאות, ובמקרה של שיבוש לתקן.
- סגנונות פיסקה ותו, קישורים להערות. כל ספר באוצריא מקודד בצורה שהתוכנה מזהה פסקאות שונות כפסקאות כותרת והדגשות של מילים באמצע פיסקה ובנוסף כוללת דף מידע על הקישורים השונים בין הטקסט הראשי להערות. המערכת כרגע אינה מסוגלת לזהות אותם באופן אוטומטי ויש ליצור אותם ידנית.
- הגהת הטקסט. ב"ה והמערכת הגיעה לתוצאות גבוהות במיוחד בזיהוי תווים אך עדיין היא יכולה לטעות. כל הגהה של הטקסט ואישור של שורות מתוקנות משמש לאימון של מודל חדש משופר יותר.
וווווווווווווווווואאאאאאאאאאאאאאווווווווווווווווווווווווווו!!!!!!!!!!!!!!!!!!!
נעתקו המילים מפי
עברתי עליו עכשיו בכתב רש"י לא מצאתי טעויות, (חוץ מהכתב המרובע), זה פשוט מדהים
אגב בנוגע לאחוזים אתמול בדיוק ראיתי פירסומת של אוצה"ח שם הם כתבו שהוא מגיע ל96.8% בממוצע ככה שזה מדהים שהצלחתם לעשות משהו כזה עם פחות משאבים, הכל בסייעתא דשמייא -
-
וווווווווווווווווואאאאאאאאאאאאאאווווווווווווווווווווווווווו!!!!!!!!!!!!!!!!!!!
נעתקו המילים מפי
עברתי עליו עכשיו בכתב רש"י לא מצאתי טעויות, (חוץ מהכתב המרובע), זה פשוט מדהים
אגב בנוגע לאחוזים אתמול בדיוק ראיתי פירסומת של אוצה"ח שם הם כתבו שהוא מגיע ל96.8% בממוצע ככה שזה מדהים שהצלחתם לעשות משהו כזה עם פחות משאבים, הכל בסייעתא דשמייא -
עוד לא הצליחו
נו נו הבדל של פחות מאחוז זה גם מדהים בעיני
-
-
-
@סתם-אחד
מה עושים במצב כזה?
הOCR זיהה את כל השורות נכון, אבל הוא מכניס את המילה חכמת - לשורה השניה, ולא מזהה את זה ככותרת (חכמת אדם)עוד שאלה - האם כותרת כזו - של הפרק, צריכה להיות מוגדרת כ"ריהוט הדף"? או שאין כותרת בגוף הטקסט על תחילת פרק יג - כך שהטקסט הזה נצרך?
עריכה:
שאפו על העיצוב והממשק והנוחות!
ממש קל לעבור על הטקטסט - עם החיצים במקלדת, מכיוון שהאתר מזהה לבד את השורה הרלוונטית ומדגיש אותה בשני החלקים - בצילום ובטקטסט המחולץ.כולם מוזמנים לנסות, זה ממש קל!
עריכה 2:
לתשומת לב המפתחים - שמתי לב שיש לו טעות קבועה (חלק מהפעמים, לא בכולם) שבה הוא מזהה את האות "מ" בכתב רש"י כ"ונ".עריכה 3:
מה עושים במקרה הבא = הוא מזהה נכון, כיון שהאות |ו" שבורה, ומבחינתו זה "י" - אבל בבאמת זה "ו". להשאיר כ "י" נכון? עריכה 4:
מה עושים במקרה כזה של האות "א-ל" מחובר? ללמד אותו שזה "א" ו "ל"? מה עושים במצב כזה?
הOCR זיהה את כל השורות נכון, אבל הוא מכניס את המילה חכמת - לשורה השניה, ולא מזהה את זה ככותרת (חכמת אדם)המערכת מזהה אותה כפיסקה אחת ולא כשורה אחת.
תלחץ על אנטר ותגדיר את חכמת ככותרת עמוד.עוד שאלה - האם כותרת כזו - של הפרק, צריכה להיות מוגדרת כ"ריהוט הדף"? או שאין כותרת בגוף הטקסט על תחילת פרק יג - כך שהטקסט הזה נצרך?
ריהוט העמוד.
לתשומת לב המפתחים - שמתי לב שיש לו טעות קבועה (חלק מהפעמים, לא בכולם) שבה הוא מזהה את האות "מ" בכתב רש"י כ"ונ".
מקווה שעל ידי התיקון כעת והאימון העתידי הוא יוכל להתמודד עם זה.
מה עושים במקרה הבא = הוא מזהה נכון, כיון שהאות |ו" שבורה, ומבחינתו זה "י" - אבל בבאמת זה "ו". להשאיר כ "י" נכון?
לצורך אימון עתידי נכון יותר להשאיר אותו כ-'. אך מכיון שזה ספר שאמור להיכנס לתוכנה נכון יותר להגיה אותו כרגע ואני מקווה שבעת המעבר על אישור שורות לאימון הוא לא יכנס.
מה עושים במקרה כזה של האות "א-ל" מחובר? ללמד אותו שזה "א" ו "ל"?
כרגע תתקן זאת ל-א' ל' אך ייתכן והוא לא יכנס לאימון.
-
-
במקומות שהמודל לא אמור לזהות את המילה כי זה בעיה בדפוס, לשנות או להשאיר?
למשל כאן: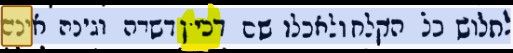
לכאורה אמור להיות ו' איפה שיש את הנקודה הזאת, אבל למודל אין איך לדעת מזה...במקומות שהמודל לא אמור לזהות את המילה כי זה בעיה בדפוס, לשנות או להשאיר?
למשל כאן:
לכאורה אמור להיות ו' איפה שיש את הנקודה הזאת, אבל למודל אין איך לדעת מזה...לתקן כפי מה שאמור להיות מוצד בספר.
מקווה שהשורה הזאת לא תיכנס לאימון עתידי.
נדרש אכן לפתח אפשרות להגדרת שורה שהיא מתוקנת שלא על פי המקור.






שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות